למה טעו מדגמי היציאה?

ניתוח נתונים סטטיסטי · הרצאת בונוס: הבחירות לכנסת, 27.10.2026

ד״ר עדי שריד

2026-11-01

מה קרה ביום שלישי

גוש נתניהו גוש השינוי
מדגמי היציאה בערוצים המרכזיים (22:00) 50 52–53
התוצאות (ספירה כמעט סופית) 53 48
הטעות ‎−3 ‎+4 עד ‎+5
  • שאר המנדטים: המפלגות הערביות
  • שיעור ההצבעה: 77.7%, הגבוה ביותר מאז 1999

השאלה להיום: האם זו טעות “רגילה” של מדגם, או שמשהו בשיטה נשבר? נעלה כמה השערות, ולכל אחת נבנה דוגמת צעצוע ב-R.

איך עובד מדגם יציאה

  1. בחירת קלפיות. מתוך כ-12 אלף קלפיות בוחרים כמה עשרות, לפי מגזר ואזור. זה מדגם אשכולות (cluster sampling): דוגמים קלפיות, לא אנשים
  2. ראיונות. בכל קלפי סוקר פונה למצביעים ביציאה, למשל לכל חמישי, והם ממלאים פתק חשאי
  3. שקלול (weighting). התוצאות מתוקנות לפי מה שידוע מראש: תוצאות הבחירות הקודמות באותה קלפי, שיעור ההצבעה הצפוי, הרכב המגזרים
  4. השעות האחרונות. הראיונות נגמרים לפני סגירת הקלפיות ב-22:00, ואת השעות האחרונות משלימים במודל
  5. המרה למנדטים. אחוז החסימה (3.25%), הסכמי עודפים, שיטת Bader–Ofer

כל שלב הוא מקור אפשרי לטעות, וכל אחת מההשערות שלנו “יושבת” על שלב אחר.

שני סוגי טעויות

\[ \underbrace{E\left[(\hat p - p)^2\right]}_{MSE} = \underbrace{V(\hat p)}_{\text{שונות: רעש מדגמי}} + \underbrace{\left(E(\hat p) - p\right)^2}_{\text{הטיה בריבוע}} \]

  • שונות (variance): המדגם יוצא קצת אחרת בכל פעם. קטנה כשמגדילים את המדגם
  • הטיה (bias): השיטה מכוונת למקום הלא נכון. לא קטנה כשמגדילים את המדגם

בכל השערה נשאל: האם היא מסבירה טעות בכיוון אחד, בכל הערוצים, בגודל של 3–5 מנדטים?

השערה 0: אולי זה סתם רעש?

כמה רועש מדגם של קלפיות?

במדגם מקרי פשוט: \(se(\hat p) = \sqrt{p(1-p)/n}\). אבל דגמנו קלפיות, ובתוך קלפי אנשים מצביעים דומה. זה מנפח את השונות פי אפקט התכנון (design effect):

\[ \text{deff} = 1 + (m - 1)\rho \qquad n_{\text{eff}} = \frac{n}{\text{deff}} \]

\(m\) = מספר המרואיינים בקלפי, \(\rho\) = המתאם בין מצביעים באותה קלפי (intra-cluster correlation).

n <- 12000; m <- 150; p <- 0.44            # 80 stations x 150 voters (toy numbers)
tibble(rho = c(0, 0.02, 0.05, 0.10)) |>
  mutate(deff = 1 + (m - 1) * rho, n_eff = n / deff,
         se_seats = to_seats(sqrt(p * (1 - p) / n_eff)))
# A tibble: 4 × 4
    rho  deff  n_eff se_seats
  <dbl> <dbl>  <dbl>    <dbl>
1  0     1    12000     0.544
2  0.02  3.98  3015.    1.08 
3  0.05  8.45  1420.    1.58 
4  0.1  15.9    755.    2.17 

רעש? כנראה לא רק רעש

  • עם \(\rho\) גבוה, שגיאת תקן של כ-2 מנדטים לגוש היא סבירה. טעות של 3 מנדטים בערוץ אחד היא לא מאוד מפתיעה
  • בפועל השקלול לפי תוצאות הבחירות הקודמות בכל קלפי מקטין את הרעש הזה מאוד. זו בעצם רגרסיה: חוזים את ההצבעה היום מתוך ההצבעה בעבר (על זה בהרצאה הבאה)
  • אבל כל הערוצים המרכזיים טעו לאותו כיוון. אם הטעויות היו רעש בלתי תלוי:
se <- 1.5                                          # seats, per channel
pnorm(-2.5, mean = 0, sd = se)^3                   # P(three channels all >= 2.5 seats low)
[1] 0.0001091
  • כשכל המדגמים טועים יחד, מחפשים הטיה משותפת: משהו בשיטה, לא במזל

השערה א: שיעור ההצבעה הגבוה

המנגנון

  • כדי לשקלל, צריך לדעת כמה אנשים הצביעו בכל קלפי. המודל מניח הרכב מצביעים שדומה לבחירות הקודמות
  • שיעור ההצבעה הגבוה (77.7%) לבדו לא מטעה. מה שמטעה הוא עלייה לא אחידה: אם העלייה גדולה יותר באזורים שנוטים לצד אחד, המשקלות הישנים מקטינים את המשקל שלהם
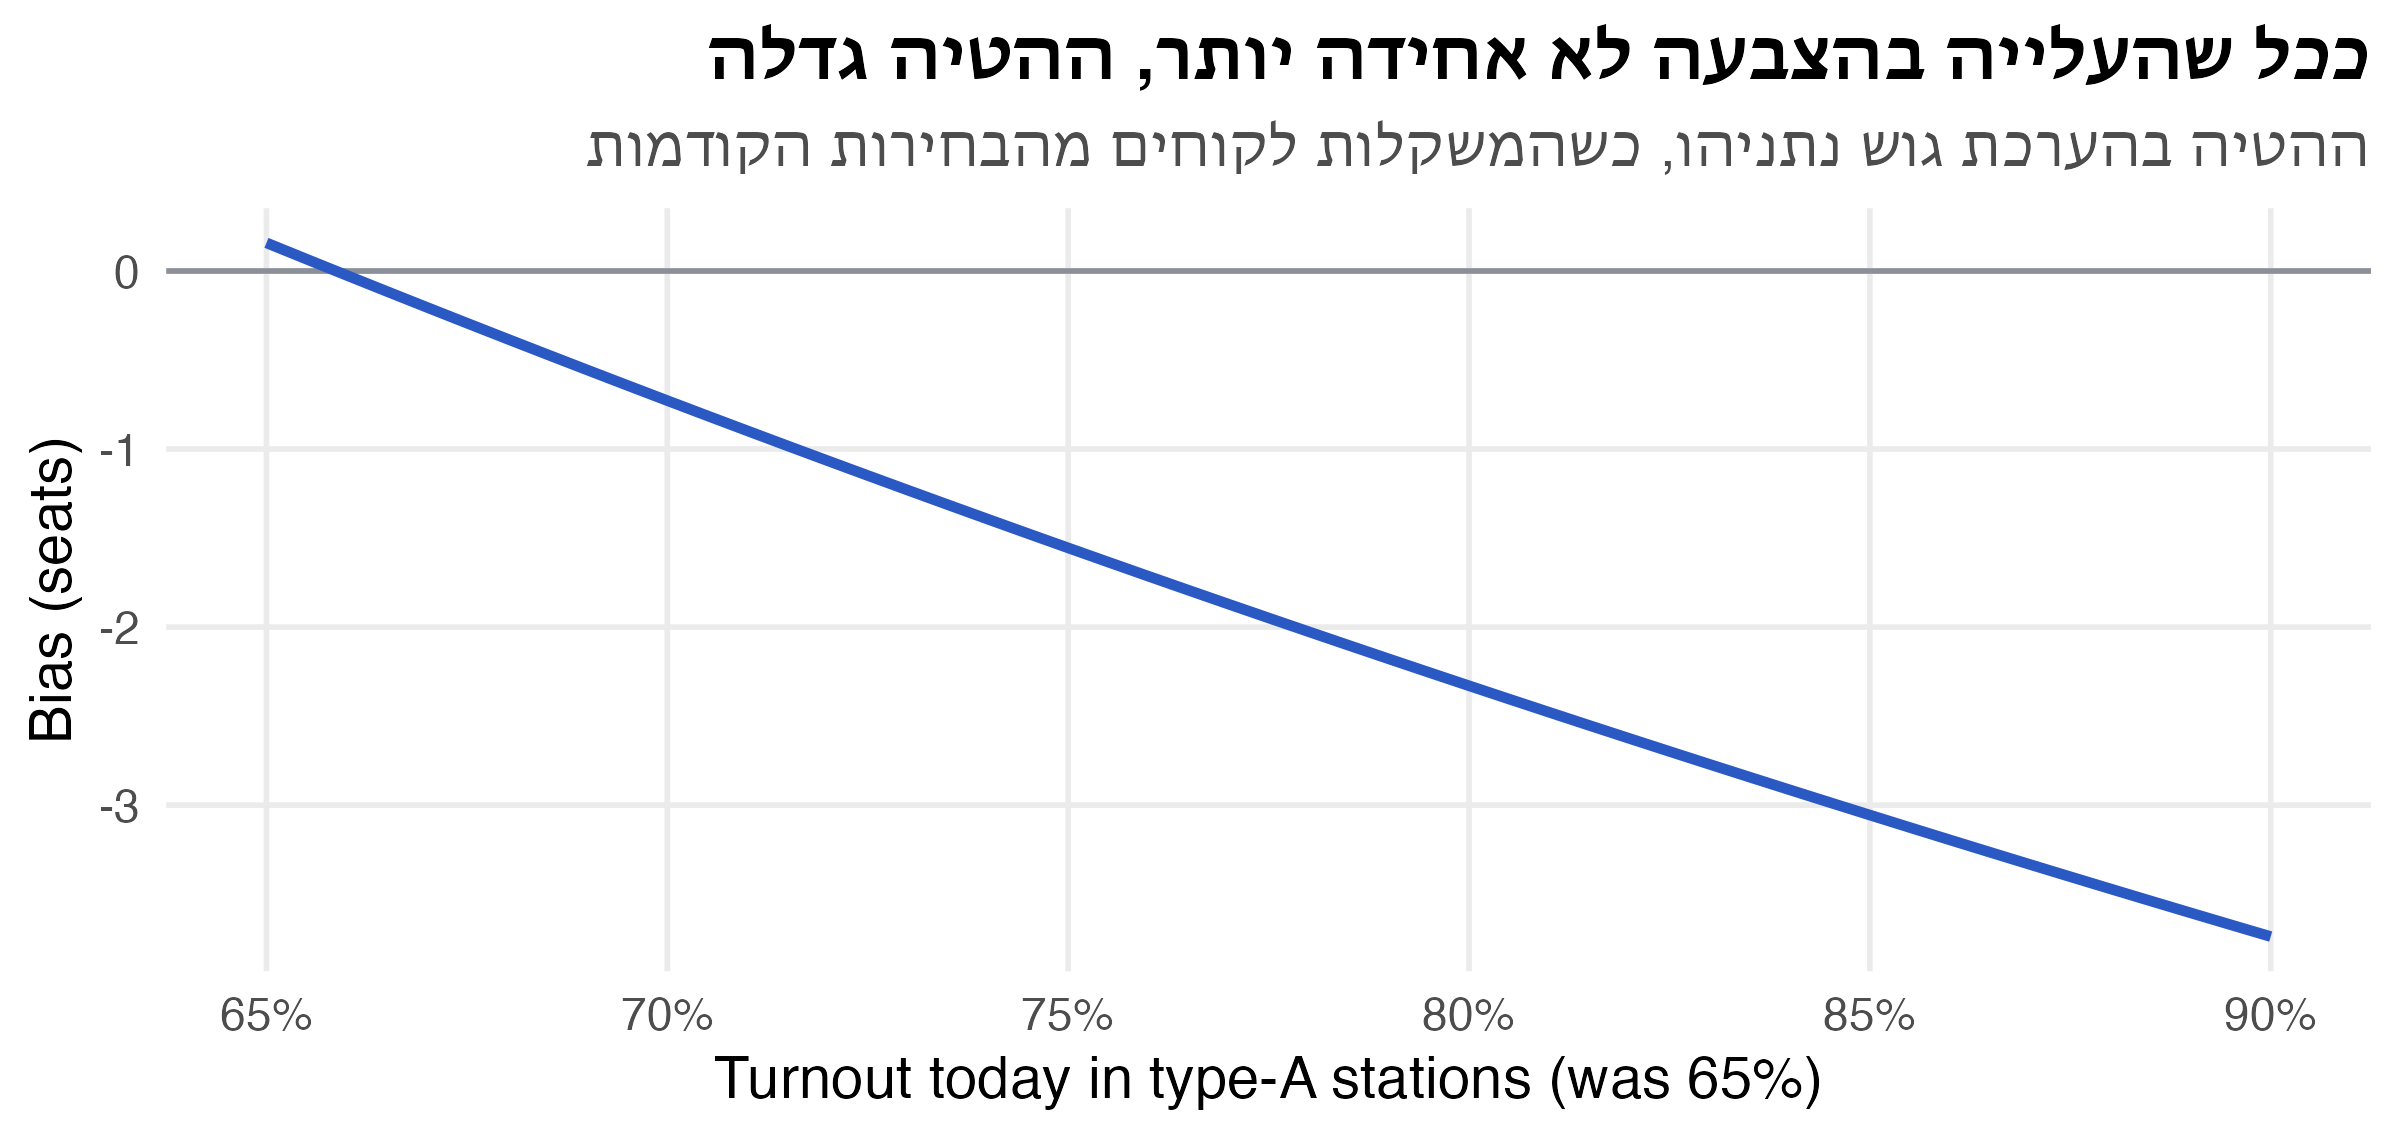
  • דוגמת צעצוע: שני סוגי קלפיות, עם אותו מספר בעלי זכות בחירה
נוטה לגוש נתניהו שיעור הצבעה בעבר שיעור הצבעה היום
קלפיות מסוג A 70% 65% 80%
קלפיות מסוג B 30% 75% 76%

דוגמת צעצוע: משקלות ישנים, עולם חדש

stations <- tibble(type = c("A", "B"), share_n = c(0.70, 0.30),
                   turnout_past = c(0.65, 0.75), turnout_now = c(0.80, 0.76))
stations |>
  summarise(estimate = weighted.mean(share_n, turnout_past),   # what the model assumes
            truth    = weighted.mean(share_n, turnout_now)) |>  # who actually voted
  mutate(bias_seats = to_seats(estimate - truth))
# A tibble: 1 × 3
  estimate truth bias_seats
     <dbl> <dbl>      <dbl>
1    0.486 0.505      -2.33
  • כל ראיון בכל קלפי מדויק. הטעות נובעת רק מהמשקלות
  • המודל מעריך את גוש נתניהו בחסר של כשני מנדטים
tibble(turnout_a = seq(0.65, 0.90, by = 0.005)) |>
  mutate(estimate = (0.70 * 0.65 + 0.30 * 0.75) / (0.65 + 0.75),
         truth    = (0.70 * turnout_a + 0.30 * 0.76) / (turnout_a + 0.76),
         bias     = to_seats(estimate - truth)) |>
  ggplot(aes(turnout_a, bias)) +
  geom_hline(yintercept = 0, colour = nanas_pal[["grey"]]) +
  geom_line(colour = nanas_pal[["primary"]], linewidth = 1.2) +
  scale_x_continuous(labels = label_percent()) +
  labs(title = "ככל שהעלייה בהצבעה לא אחידה יותר, ההטיה גדלה",
       subtitle = "ההטיה בהערכת גוש נתניהו, כשהמשקלות לקוחים מהבחירות הקודמות",
       x = "Turnout today in type-A stations (was 65%)", y = "Bias (seats)")

דוגמת צעצוע: משקלות ישנים, עולם חדש

השערה ב: אי-השתתפות דיפרנציאלית

המנגנון

הטיית אי-השבה (non-response bias): מי שמסרב להשתתף שונה ממי שמשתתף.

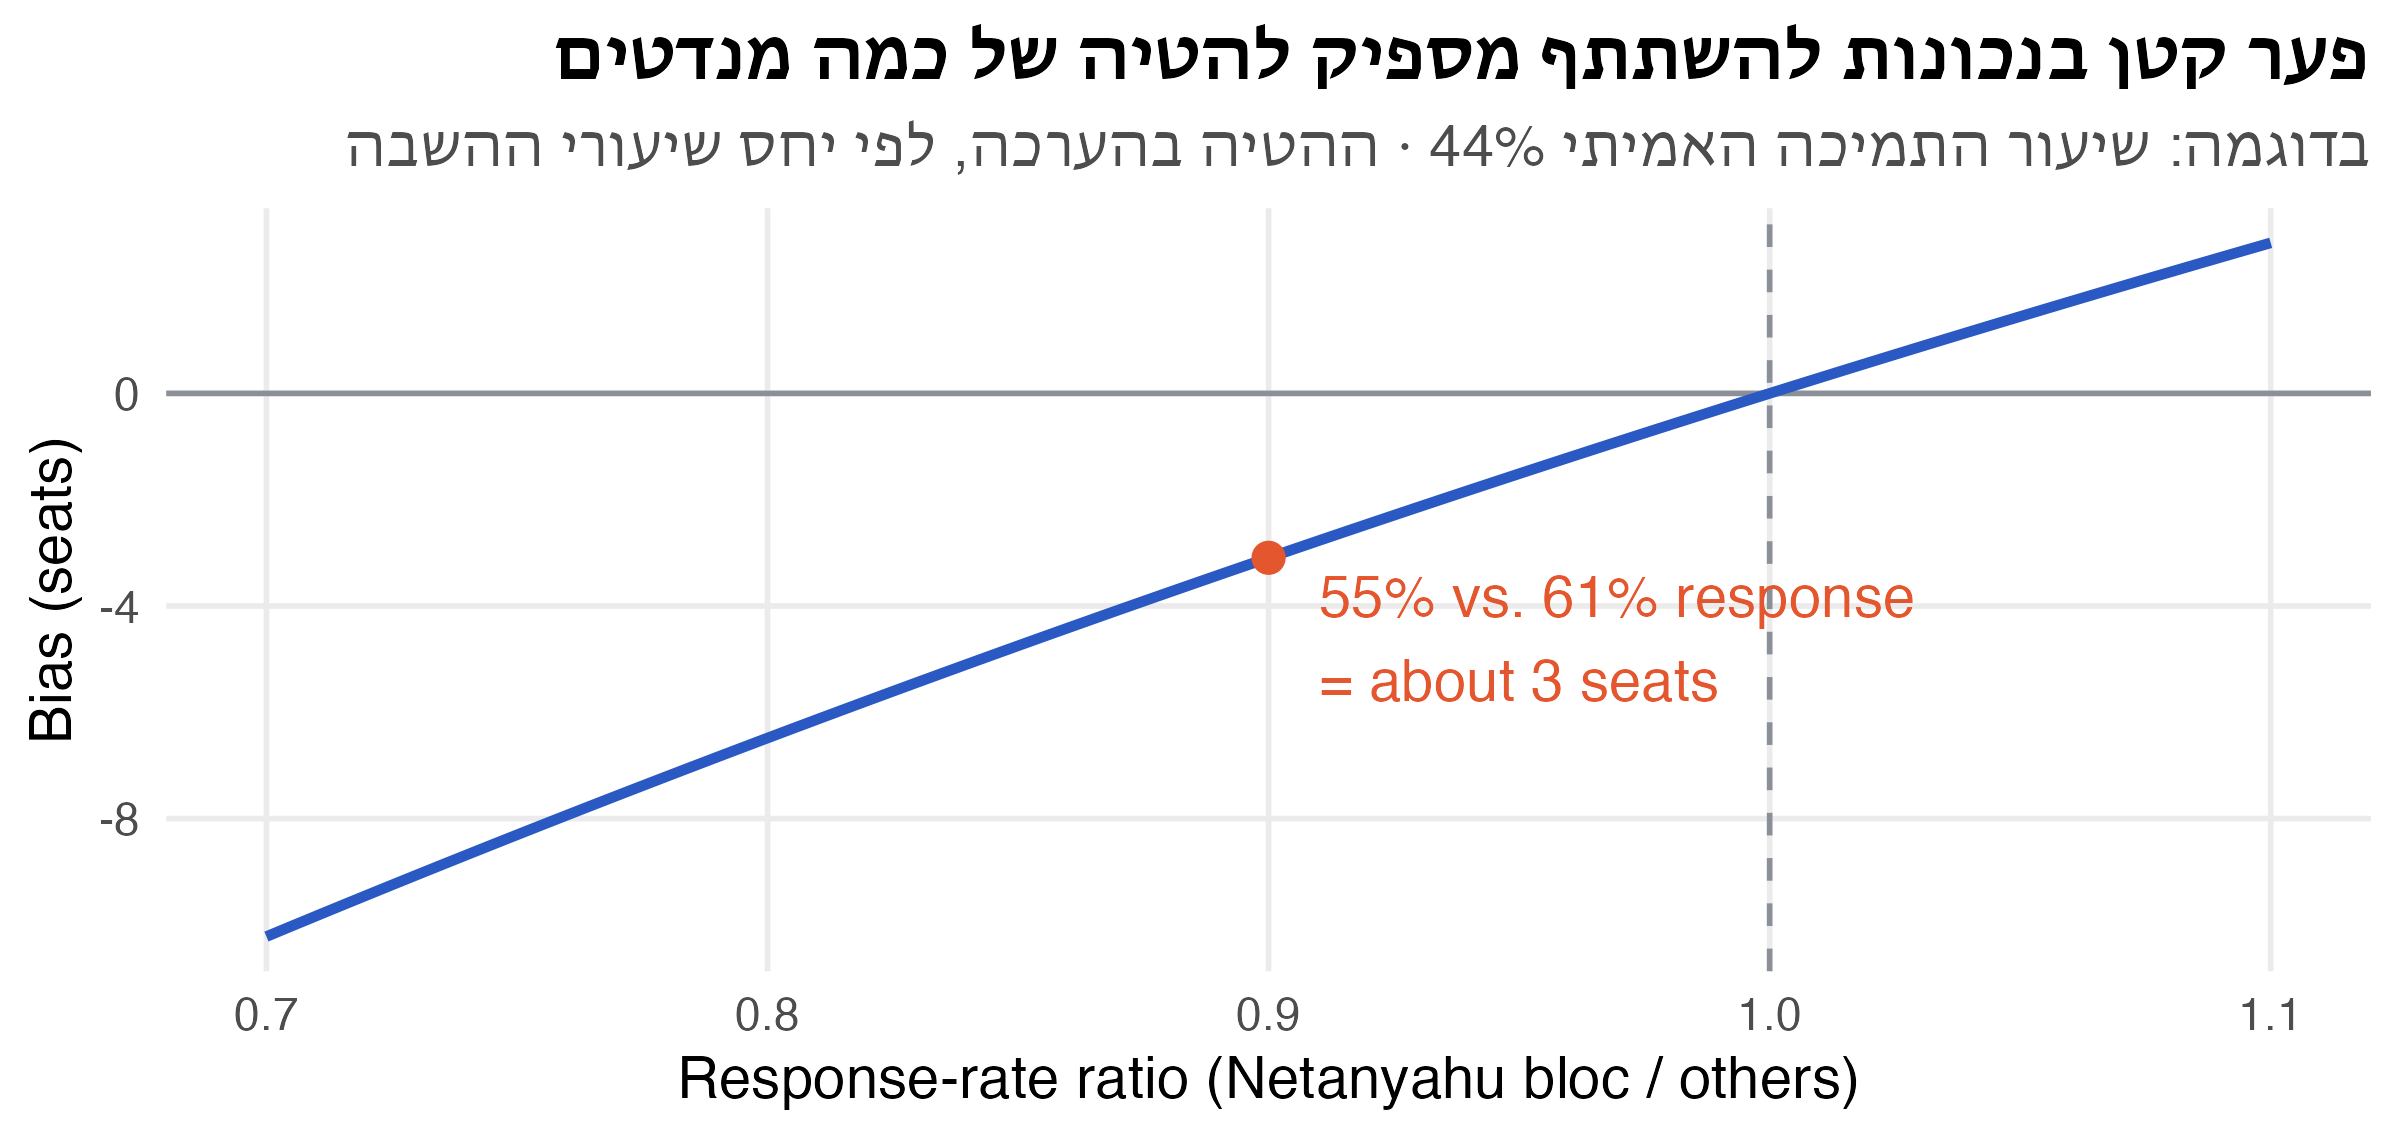
נניח שבאוכלוסייה שיעור תומכי גוש נתניהו הוא \(p\), שתומכיו משיבים בהסתברות \(r_1\), ושהאחרים משיבים בהסתברות \(r_0\). מה נראה במדגם?

\[ \tilde p = \frac{p \, r_1}{p \, r_1 + (1 - p)\, r_0} \]

  • אם \(r_1 = r_0\), אז \(\tilde p = p\): אין הטיה, גם כשרבים מסרבים
  • ההטיה תלויה ביחס \(r_1 / r_0\), ולא בשיעור ההשבה עצמו
  • למה “לפי ערוץ”? מצביע שלא סומך על ערוץ מסוים יסרב דווקא לסוקר שלו. ערוץ 14 פרסם 60 מול 43, כלומר טעה בכיוון ההפוך. זה מתאים להשערה שההשתתפות תלויה באמון בערוץ

כמה זה משנה?

p_true <- 0.44                                # toy value, close to 53 of 120 seats
observed_share <- function(ratio) p_true * ratio / (p_true * ratio + (1 - p_true))

tibble(ratio = seq(0.7, 1.1, by = 0.005)) |>
  mutate(bias = to_seats(observed_share(ratio) - p_true)) |>
  ggplot(aes(ratio, bias)) +
  geom_hline(yintercept = 0, colour = nanas_pal[["grey"]]) +
  geom_vline(xintercept = 1, colour = nanas_pal[["grey"]], linetype = "dashed") +
  geom_line(colour = nanas_pal[["primary"]], linewidth = 1.2) +
  annotate("point", x = 0.9, y = to_seats(observed_share(0.9) - p_true), size = 3,
           colour = nanas_pal[["accent"]]) +
  annotate("text", x = 0.91, y = to_seats(observed_share(0.9) - p_true) - 1.5, hjust = 0,
           colour = nanas_pal[["accent"]],
           label = "55% vs. 61% response\n= about 3 seats") +
  labs(title = "פער קטן בנכונות להשתתף מספיק להטיה של כמה מנדטים",
       subtitle = "בדוגמה: שיעור התמיכה האמיתי 44% · ההטיה בהערכה, לפי יחס שיעורי ההשבה",
       x = "Response-rate ratio (Netanyahu bloc / others)", y = "Bias (seats)")

כמה זה משנה?

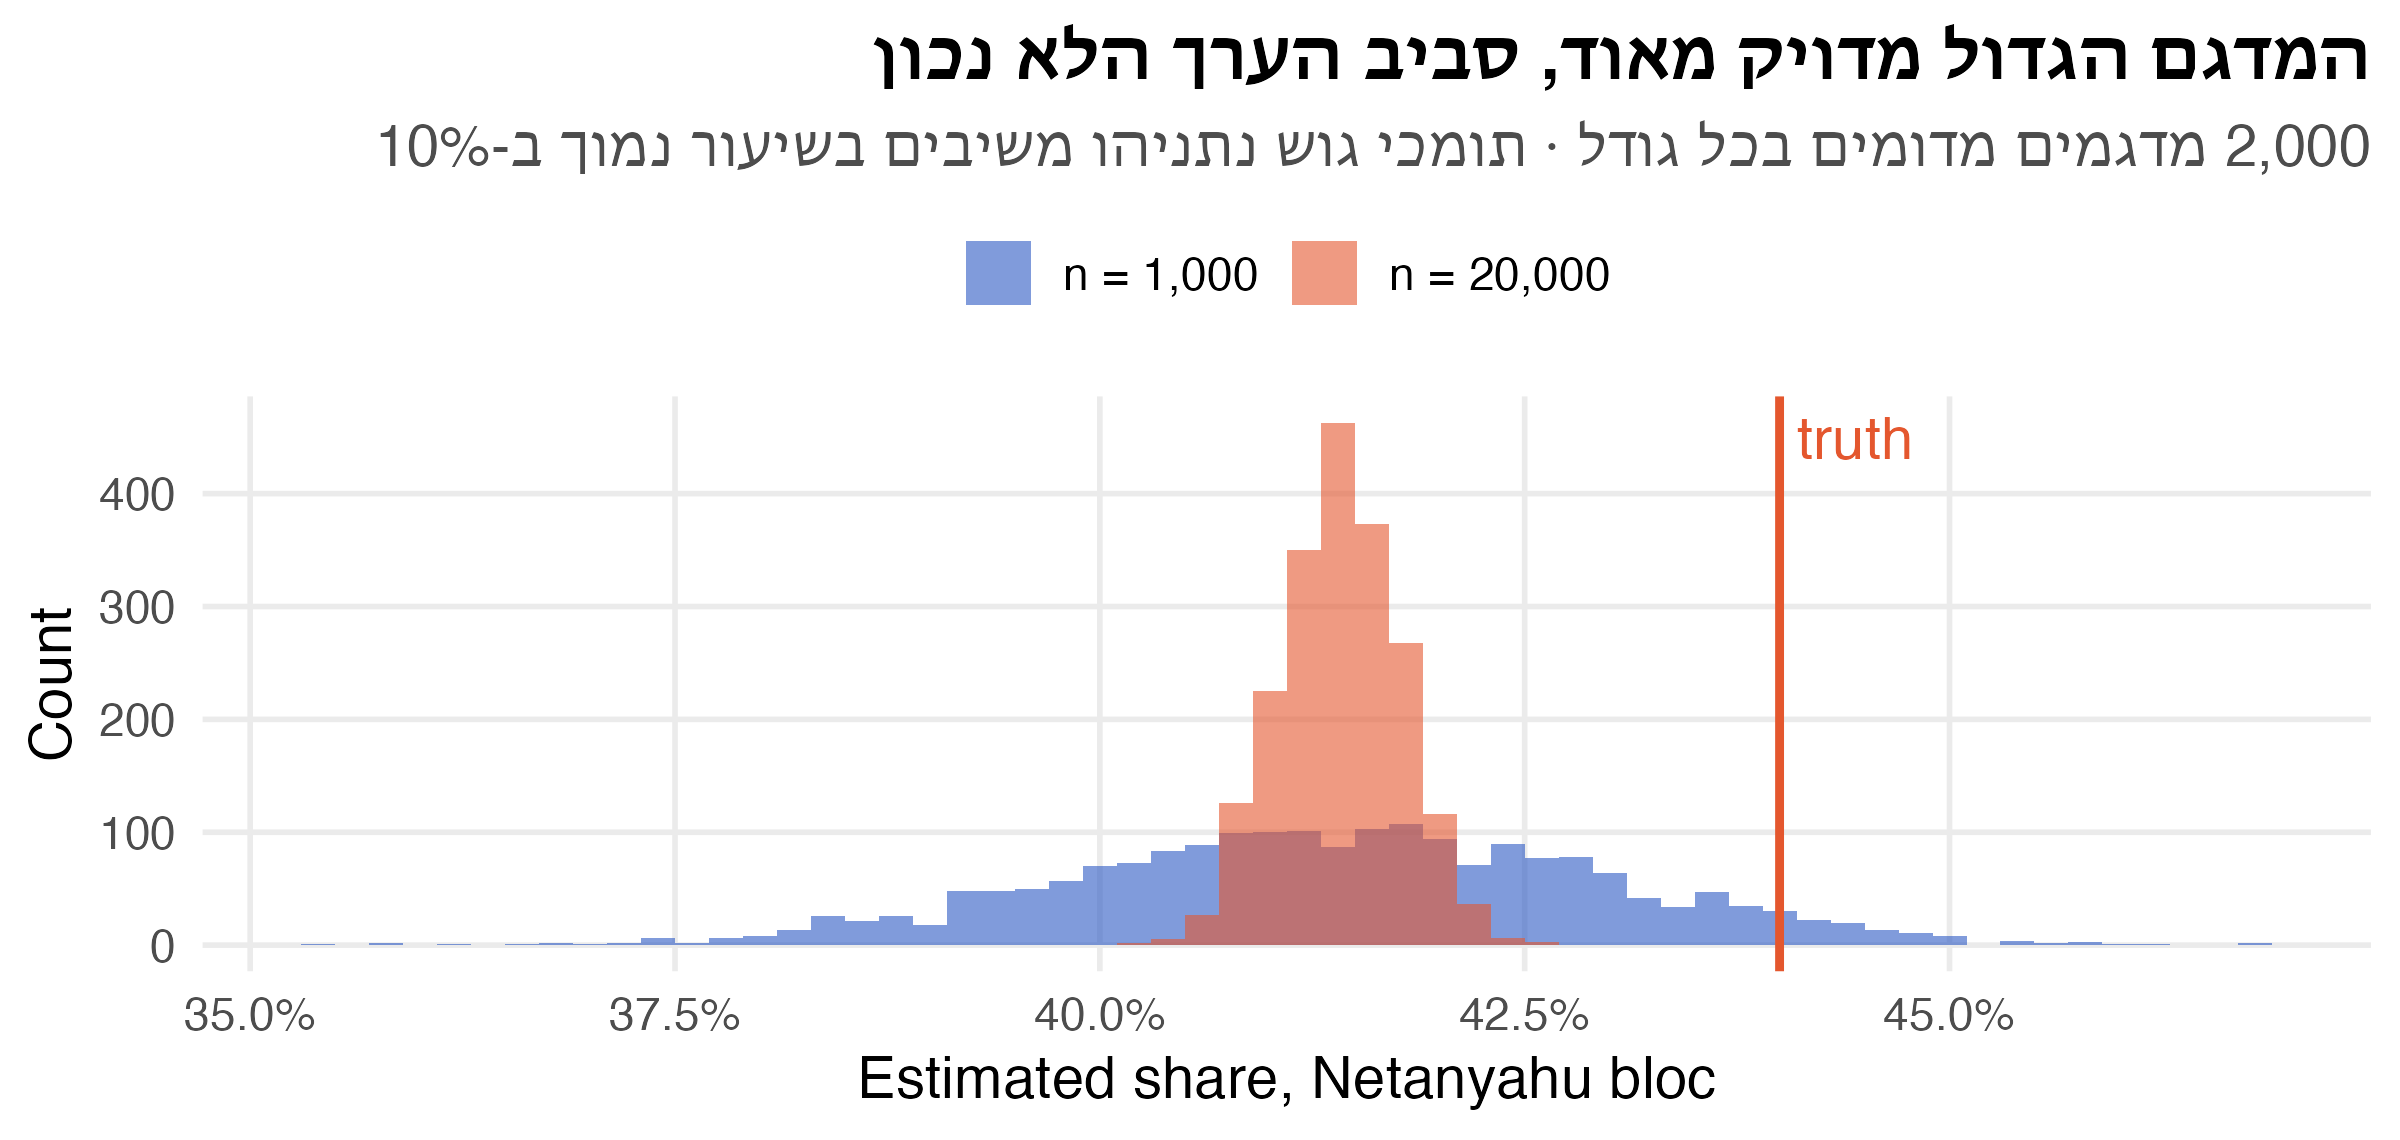
מדגם גדול יותר לא יעזור

נדמה 2,000 מדגמים, בגודל 1,000 ובגודל 20,000, כש-\(r_1 / r_0 = 0.9\):

p_obs <- observed_share(0.9)                  # what a respondent pool looks like
sims_nr <- expand_grid(n = c(1000, 20000), rep = 1:2000) |>
  mutate(estimate = rbinom(n(), n, p_obs) / n,
         n = factor(n, labels = c("n = 1,000", "n = 20,000")))

ggplot(sims_nr, aes(estimate, fill = n)) +
  geom_histogram(binwidth = 0.002, position = "identity", alpha = 0.6) +
  geom_vline(xintercept = p_true, colour = nanas_pal[["accent"]], linewidth = 1) +
  annotate("text", x = p_true + 0.001, y = Inf, vjust = 1.5, hjust = 0, label = "truth",
           colour = nanas_pal[["accent"]]) +
  scale_x_continuous(labels = label_percent()) +
  labs(title = "המדגם הגדול מדויק מאוד, סביב הערך הלא נכון",
       subtitle = "2,000 מדגמים מדומים בכל גודל · תומכי גוש נתניהו משיבים בשיעור נמוך ב-10%",
       x = "Estimated share, Netanyahu bloc", y = "Count", fill = NULL)

מדגם גדול יותר לא יעזור

השערה ג: מדגם האשכולות לא תוכנן טוב

המנגנון

אפשר לטעות בבחירת הקלפיות בשתי דרכים:

  • שונות גדולה: מעט קלפיות, וכל אחת הומוגנית. ראינו את זה בהשערה 0
  • הטיה: הקלפיות שנבחרו לא מייצגות. למשל:
    • המסגרת מבוססת על מפת הבחירות הקודמות, אבל האוכלוסייה זזה: שכונות חדשות, ערים שגדלו מהר
    • יש קלפיות שקשה או לא נוח לסקור בהן, והן מוחלפות בקלפיות “דומות” שאינן באמת דומות
    • אם כל הערוצים מוותרים על אותו סוג קלפיות, כולם יטעו יחד

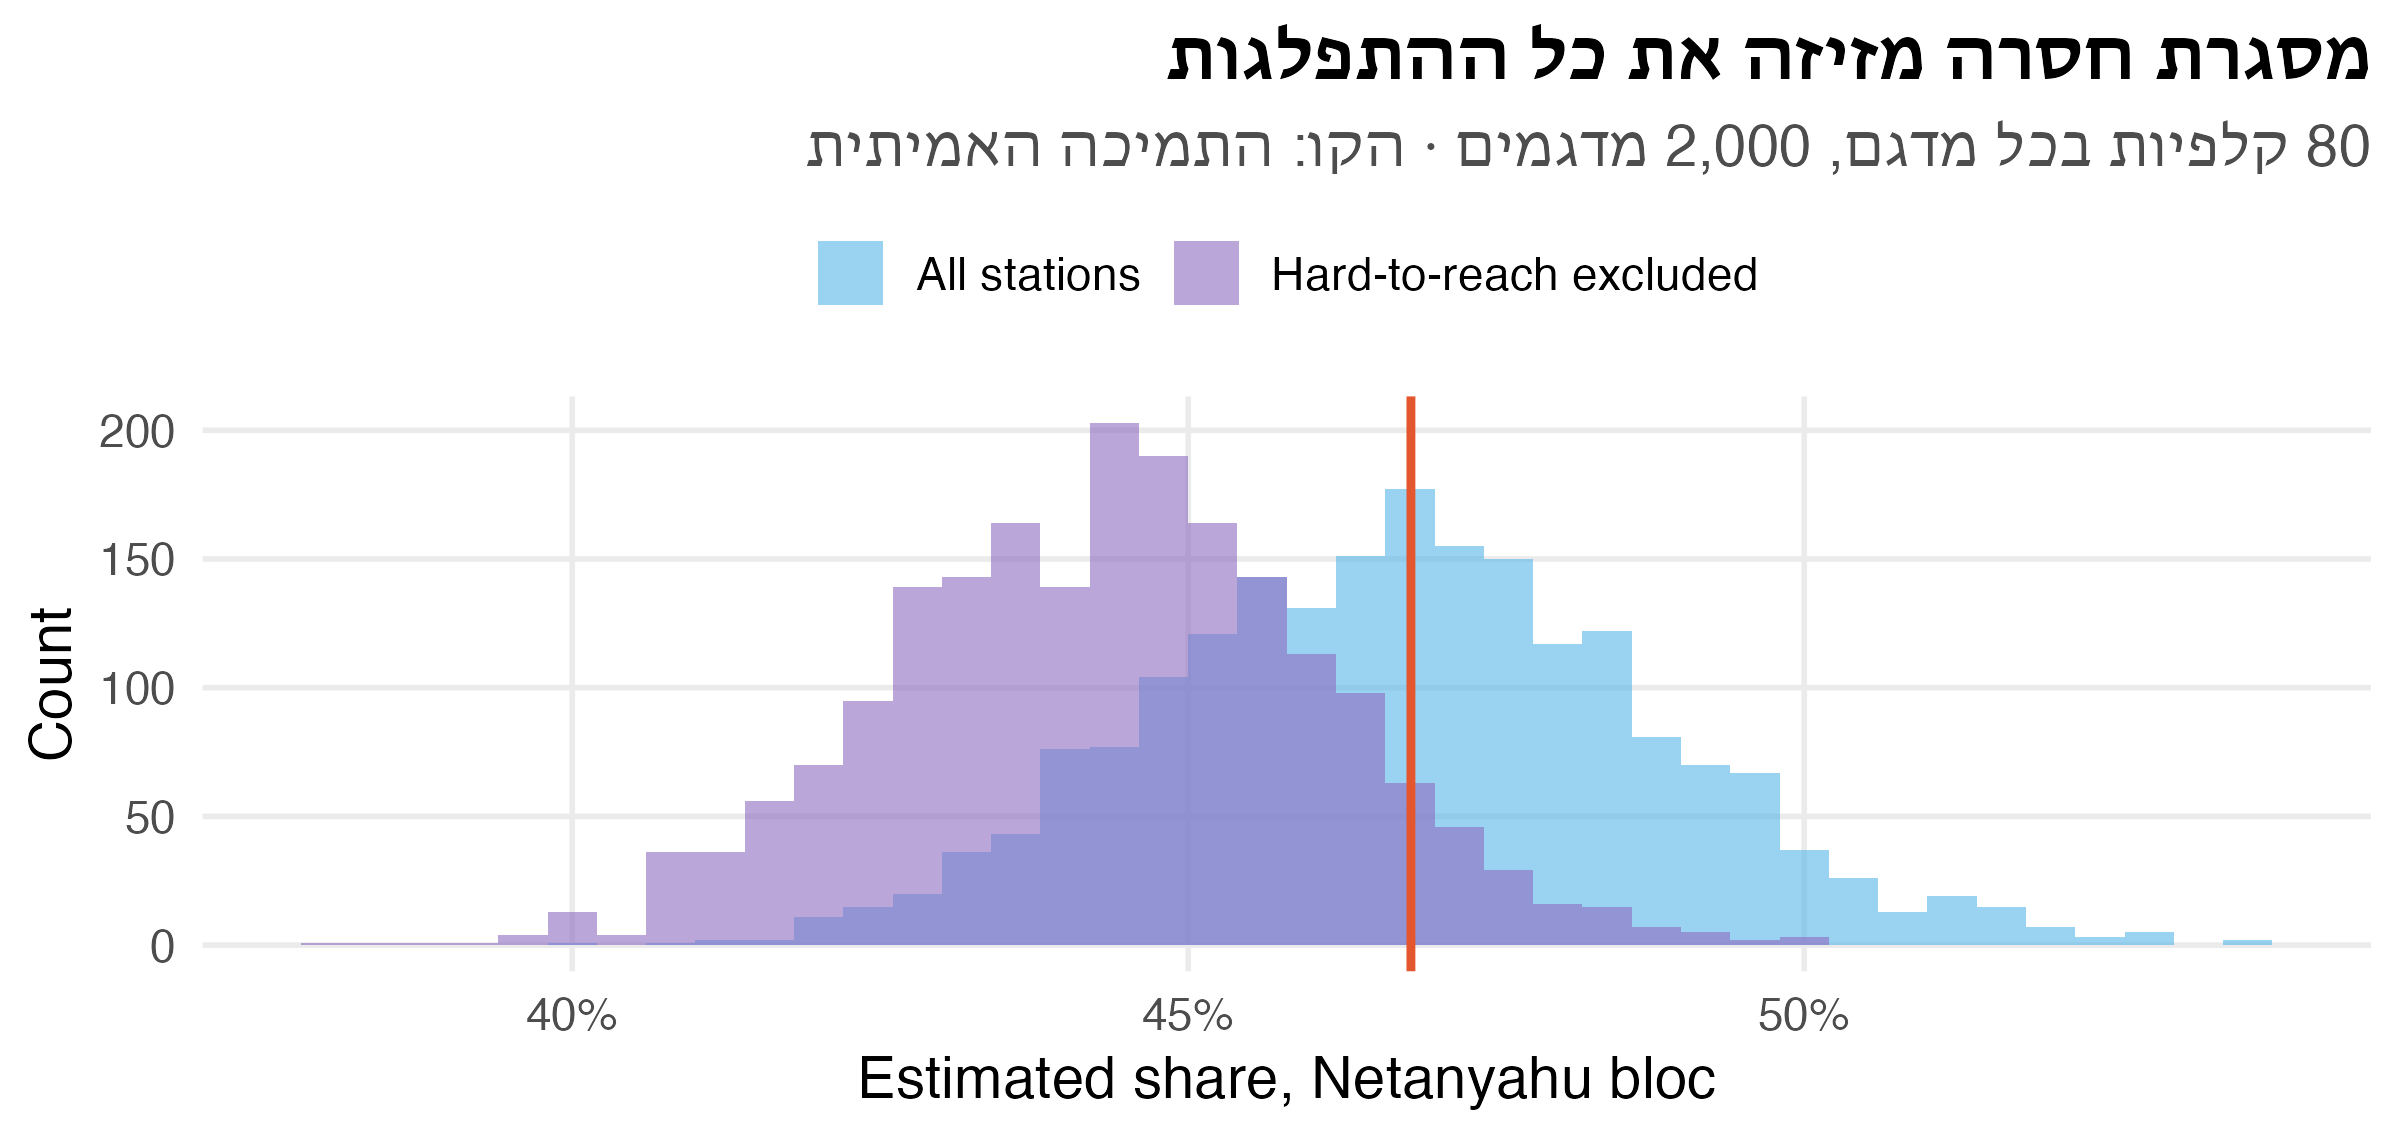
דוגמת צעצוע: 12 אלף קלפיות. ב-7% מהן, “קשות להגעה”, התמיכה בגוש נתניהו גבוהה במיוחד. דוגמים 80 קלפיות, פעם מכל הקלפיות ופעם בלי הקלפיות הקשות.

דוגמת צעצוע: מי חסר במסגרת

set.seed(2710)
pop <- tibble(hard    = runif(12000) < 0.07,
              voters  = rpois(12000, 450),
              share_n = if_else(hard, rbeta(12000, 8, 2), rbeta(12000, 4, 5)))
truth <- weighted.mean(pop$share_n, pop$voters)

draw <- function(frame) {
  s <- slice_sample(frame, n = 80)
  weighted.mean(s$share_n, s$voters)
}
sims_cl <- bind_rows(
  tibble(frame = "All stations",           estimate = replicate(2000, draw(pop))),
  tibble(frame = "Hard-to-reach excluded", estimate = replicate(2000, draw(filter(pop, !hard)))))

ggplot(sims_cl, aes(estimate, fill = frame)) +
  geom_histogram(binwidth = 0.004, position = "identity", alpha = 0.6) +
  geom_vline(xintercept = truth, colour = nanas_pal[["accent"]], linewidth = 1) +
  scale_x_continuous(labels = label_percent()) +
  scale_fill_manual(values = c(nanas_pal[["sky"]], nanas_pal[["purple"]])) +
  labs(title = "מסגרת חסרה מזיזה את כל ההתפלגות",
       subtitle = "80 קלפיות בכל מדגם, 2,000 מדגמים · הקו: התמיכה האמיתית",
       x = "Estimated share, Netanyahu bloc", y = "Count", fill = NULL)

דוגמת צעצוע: מי חסר במסגרת

מה רואים

sims_cl |>
  group_by(frame) |>
  summarise(mean = mean(estimate), sd = sd(estimate)) |>
  mutate(bias_seats = to_seats(mean - truth), sd_seats = to_seats(sd))
# A tibble: 2 × 5
  frame                   mean     sd bias_seats sd_seats
  <chr>                  <dbl>  <dbl>      <dbl>    <dbl>
1 All stations           0.468 0.0200    -0.0520     2.41
2 Hard-to-reach excluded 0.443 0.0175    -2.97       2.10
  • מכל הקלפיות: בממוצע המדגם צודק, אבל עם 80 קלפיות בלבד הפיזור גדול (השערה 0)
  • בלי הקלפיות הקשות: הפיזור דומה, וכל ההתפלגות זזה. הטיה של כ-3 מנדטים
  • שקלול לפי מגזר לא מציל אותנו אם אף קלפי מהמגזר לא נדגמה, או אם הקלפיות “המחליפות” שונות מאלה שהוחלפו

השערה ד: הצבעה מאוחרת וקמפיין “גוועלד”

המנגנון

  • קמפיין “גוועלד”: בשעות אחר הצהריים מפלגה קוראת לתומכים שלה: “המצב חמור, צאו להצביע עכשיו”
  • אם הקריאה עובדת, בשעות האחרונות מגיעים הרבה מצביעים, ובעיקר מצד אחד של המפה
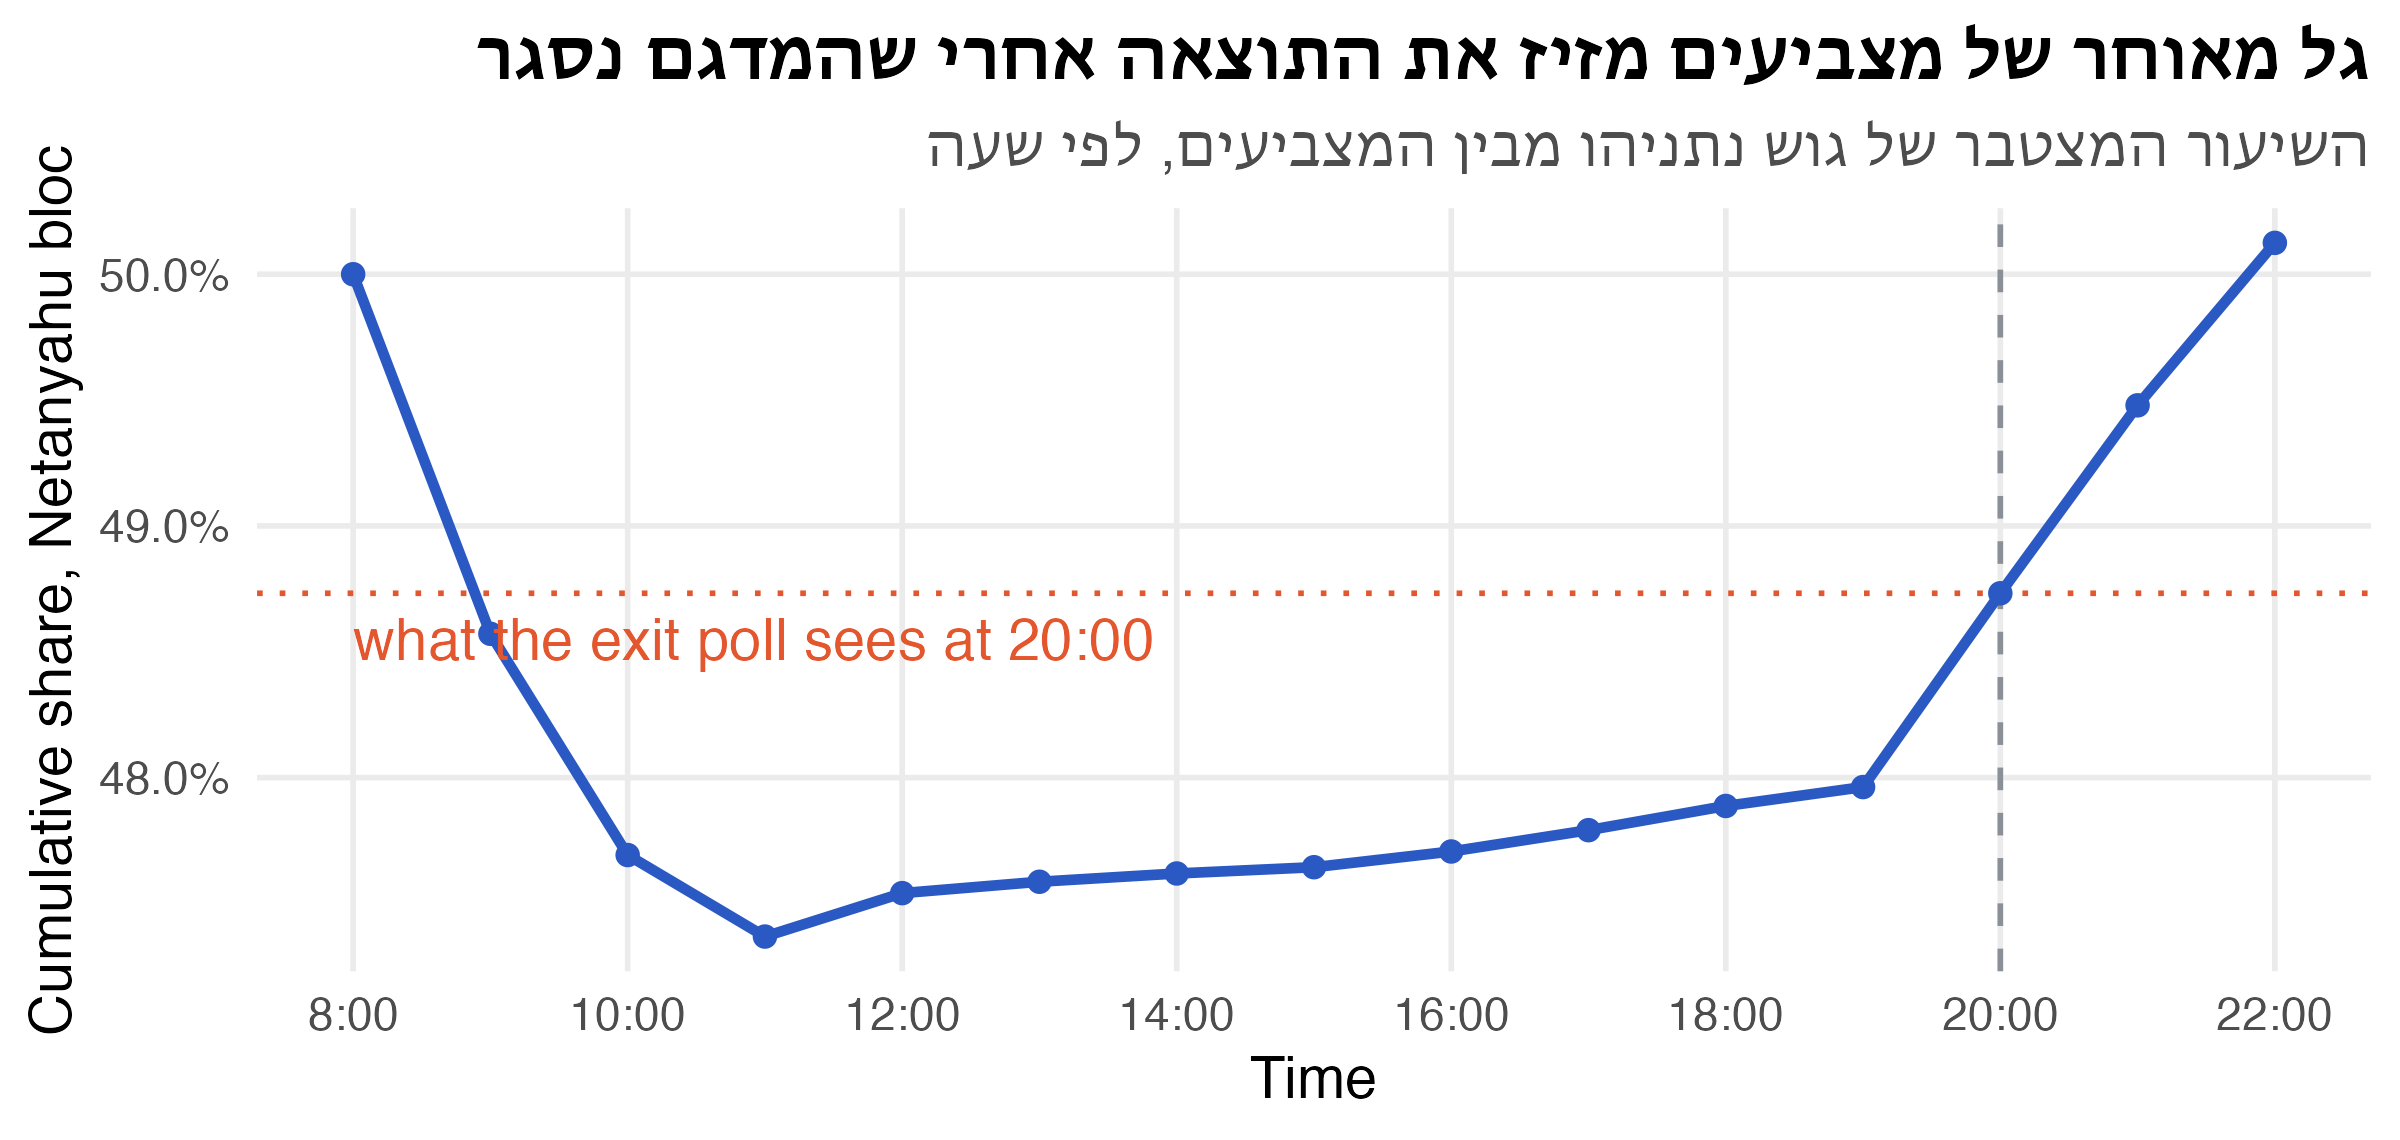
  • הראיונות נגמרים לפני 22:00. המודל מניח שמי שמצביע בשעות האחרונות דומה למי שהצביע קודם
  • רמז מהשטח: לפי הדיווחים, המדגמים “המעודכנים” שפורסמו מאוחר יותר בלילה זזו לכיוון התוצאות. זה מתאים להשערה הזו, אבל גם לכל השערה שבה “עוד נתונים” עוזרים

דוגמת צעצוע: מי מצביע בשעה האחרונה

votes <- tibble(hour   = 7:21,                                # hour the vote was cast
                other  = c(3, 6, 8, 8, 7, 6, 6, 6, 7, 8, 9, 9, 8, 6, 3),
                n_bloc = c(3, 5.5, 7, 7, 6.5, 5.5, 5.5, 5.5, 6.5, 7.5, 8.5, 8.5, 7.5, 6, 3)) |>
  mutate(n_bloc = n_bloc + if_else(hour >= 19, 2.5, 0),       # late "gevalt" surge
         share  = cumsum(n_bloc) / cumsum(n_bloc + other))

cutoff <- 20                                                  # last interviews
estimate <- votes$share[votes$hour == cutoff - 1]             # extrapolated to the close
final    <- last(votes$share)

ggplot(votes, aes(hour + 1, share)) +
  geom_vline(xintercept = cutoff, colour = nanas_pal[["grey"]], linetype = "dashed") +
  geom_hline(yintercept = estimate, colour = nanas_pal[["accent"]], linetype = "dotted") +
  geom_line(colour = nanas_pal[["primary"]], linewidth = 1.2) +
  geom_point(colour = nanas_pal[["primary"]]) +
  annotate("text", x = 8, y = estimate - 0.001, hjust = 0, vjust = 1, colour = nanas_pal[["accent"]],
           label = "what the exit poll sees at 20:00") +
  scale_x_continuous(breaks = seq(8, 22, 2), labels = \(h) paste0(h, ":00")) +
  scale_y_continuous(labels = label_percent(accuracy = 0.1)) +
  labs(title = "גל מאוחר של מצביעים מזיז את התוצאה אחרי שהמדגם נסגר",
       subtitle = "השיעור המצטבר של גוש נתניהו מבין המצביעים, לפי שעה",
       x = "Time", y = "Cumulative share, Netanyahu bloc")
דוגמת צעצוע: מי מצביע בשעה האחרונה

כמה זה שווה במנדטים?

c(at_20 = estimate, final = final, bias_seats = to_seats(estimate - final))
     at_20      final bias_seats 
    0.4873     0.5012    -1.6708 

עוד השערות

עוד חשודים

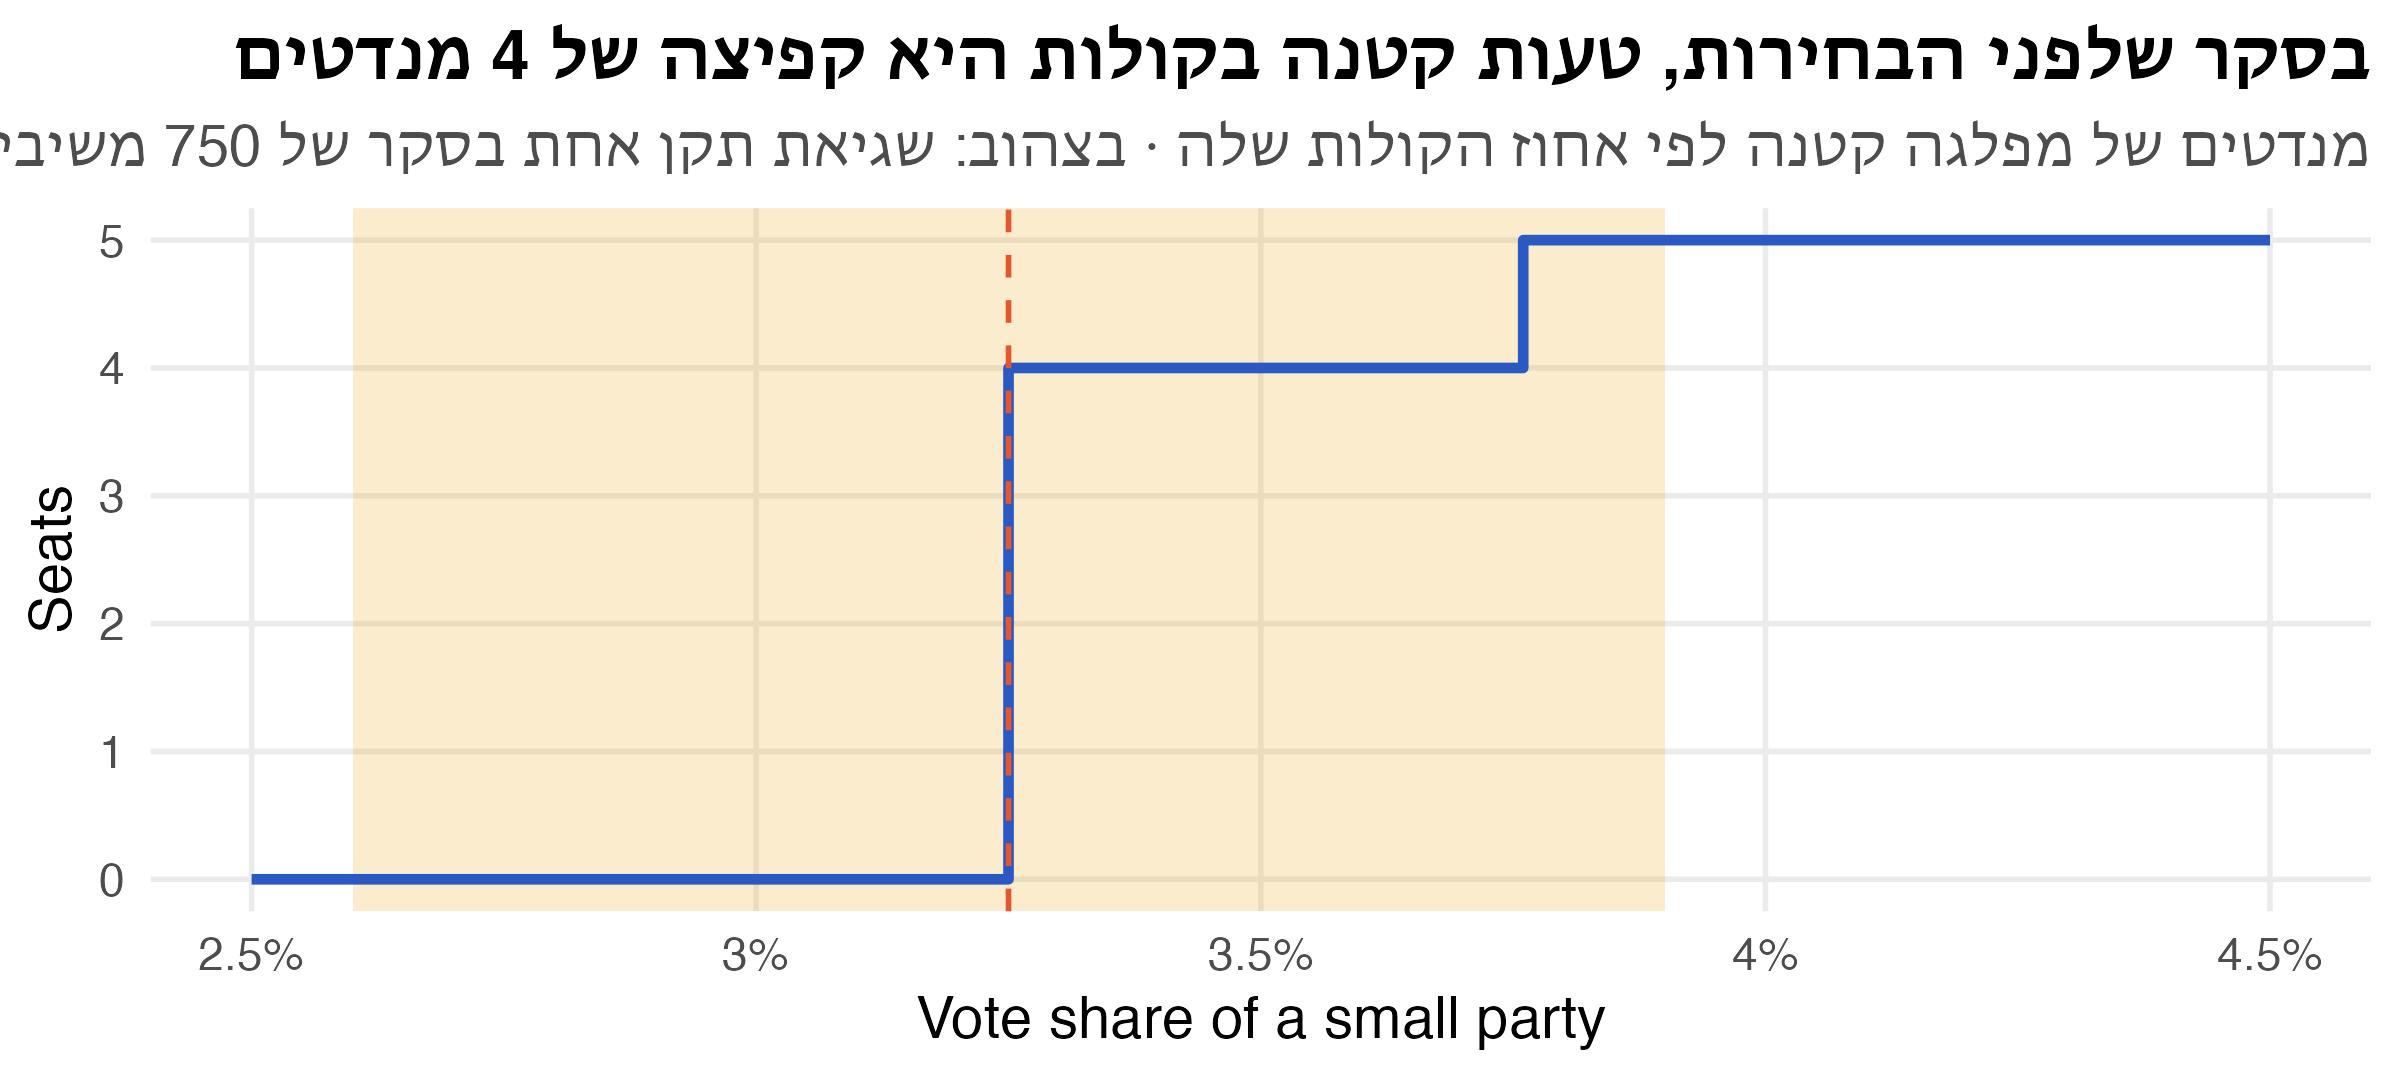
  • ה. אחוז החסימה: בסקרים שלפני הבחירות, לא במדגם היציאה. ההמרה מקולות למנדטים לא לינארית. מפלגה עם 3.1% מקבלת 0 מנדטים, ועם 3.3% מקבלת 4. בסקר של כמה מאות משיבים, טעות קטנה באחוזים על מפלגה אחת קרובה לסף הופכת לטעות של 4 מנדטים בגוש
  • ו. מעטפות כפולות. חיילים, אסירים, מאושפזים, שליחים בחו״ל ועוד מצביעים מחוץ לקלפי הרגילה. הם לא נמצאים במדגם היציאה, והקולות שלהם נספרים אחרונים. אם הם נוטים לצד אחד, הם מזיזים את התוצאה הסופית
  • ז. המצביע הביישן (shy voter). משתתף, אבל לא מדווח את ההצבעה האמיתית. אותה מתמטיקה כמו השערה ב
  • ח. טעויות מתואמות. חברות המדגם משתמשות בשיטות דומות ומכיילות לפי אותם סקרים מוקדמים. כשכולן מסכימות, זה לא אומר שהן צודקות

סקרים שלפני הבחירות: אחוז החסימה

tibble(vote_share = seq(2.5, 4.5, by = 0.01)) |>
  mutate(seats = if_else(vote_share >= 3.25, round(vote_share / 100 * 120), 0)) |>
  ggplot(aes(vote_share, seats)) +
  annotate("rect", xmin = 3.25 - 0.65, xmax = 3.25 + 0.65, ymin = -Inf, ymax = Inf,
           fill = nanas_pal[["yellow"]], alpha = 0.2) +
  geom_step(colour = nanas_pal[["primary"]], linewidth = 1.2) +
  geom_vline(xintercept = 3.25, colour = nanas_pal[["accent"]], linetype = "dashed") +
  scale_x_continuous(labels = \(x) paste0(x, "%")) +
  labs(title = "בסקר שלפני הבחירות, טעות קטנה בקולות היא קפיצה של 4 מנדטים",
       subtitle = "מנדטים של מפלגה קטנה לפי אחוז הקולות שלה · בצהוב: שגיאת תקן אחת בסקר של 750 משיבים",
       x = "Vote share of a small party", y = "Seats")

איך מכריעים בין ההשערות?

לכל השערה יש חתימה משלה

השערה מה היא חוזה איך בודקים
0. רעש טעויות בכיוונים שונים בערוצים שונים ✗ כולם טעו לאותו כיוון
א. שיעור הצבעה הטעות גדולה יותר בקלפיות עם עלייה חדה בהצבעה שיעור ההצבעה בכל קלפי, היום מול הקודמות
ב. אי-השתתפות בקלפיות שנדגמו, המדגם שונה מהתוצאה של אותה קלפי השוואה ברמת הקלפי, שיעורי סירוב לפי ערוץ
ג. בחירת קלפיות התוצאה האמיתית בקלפיות שנדגמו שונה מהתוצאה הארצית השוואת הקלפיות שנדגמו לכלל הקלפיות
ד. הצבעה מאוחרת הטעות מתרכזת בשעות האחרונות ראיונות לפי שעה, המדגמים המעודכנים
ו. מעטפות כפולות הפער קטן כשמשווים לספירה בלי המעטפות ספירה לפני ואחרי המעטפות

הכלי החזק ביותר: פירוק הטעות

אחרי הבחירות ועדת הבחירות מפרסמת את התוצאה בכל קלפי. אז אפשר לפרק את הטעות לשני חלקים:

\[ \hat p - p = \underbrace{(\bar p_S - p)}_{\text{הקלפיות שנבחרו (ג)}} + \underbrace{(\hat p - \bar p_S)}_{\text{הראיונות בתוך הקלפיות (ב, ד, ז)}} \]

  • \(\hat p\): מה שהמדגם אמר
  • \(\bar p_S\): התוצאה האמיתית בקלפיות שנדגמו
  • \(p\): התוצאה הארצית

אם \(\bar p_S \approx p\), הקלפיות נבחרו טוב והבעיה בראיונות. אם \(\hat p \approx \bar p_S\), הראיונות טובים והבעיה בבחירת הקלפיות. בשני המקרים, הנתונים כבר קיימים: צריך רק לפרסם אותם.

מה לקחת

  • שונות מול הטיה. מדגם גדול מקטין את השונות, לא את ההטיה. כשכל המדגמים טועים לאותו כיוון, מחפשים הטיה
  • מדגם אשכולות רועש בהרבה ממה שמספר המרואיינים מרמז: \(n_{\text{eff}} = n / \text{deff}\)
  • משקלות הם הנחות. הם נלמדים מהעבר, ונשברים כשהעולם משתנה: שיעור הצבעה, מי משתתף, מתי מצביעים
  • פונקציות לא לינאריות (אחוז החסימה בסקרים שלפני הבחירות) מגדילות טעויות קטנות
  • השערה טובה היא השערה שאפשר לבדוק. לכל השערה יש חתימה בנתונים

ובהרצאה של היום: שקלול לפי תוצאות העבר הוא בעצם רגרסיה. בואו נלמד רגרסיה מרובה.