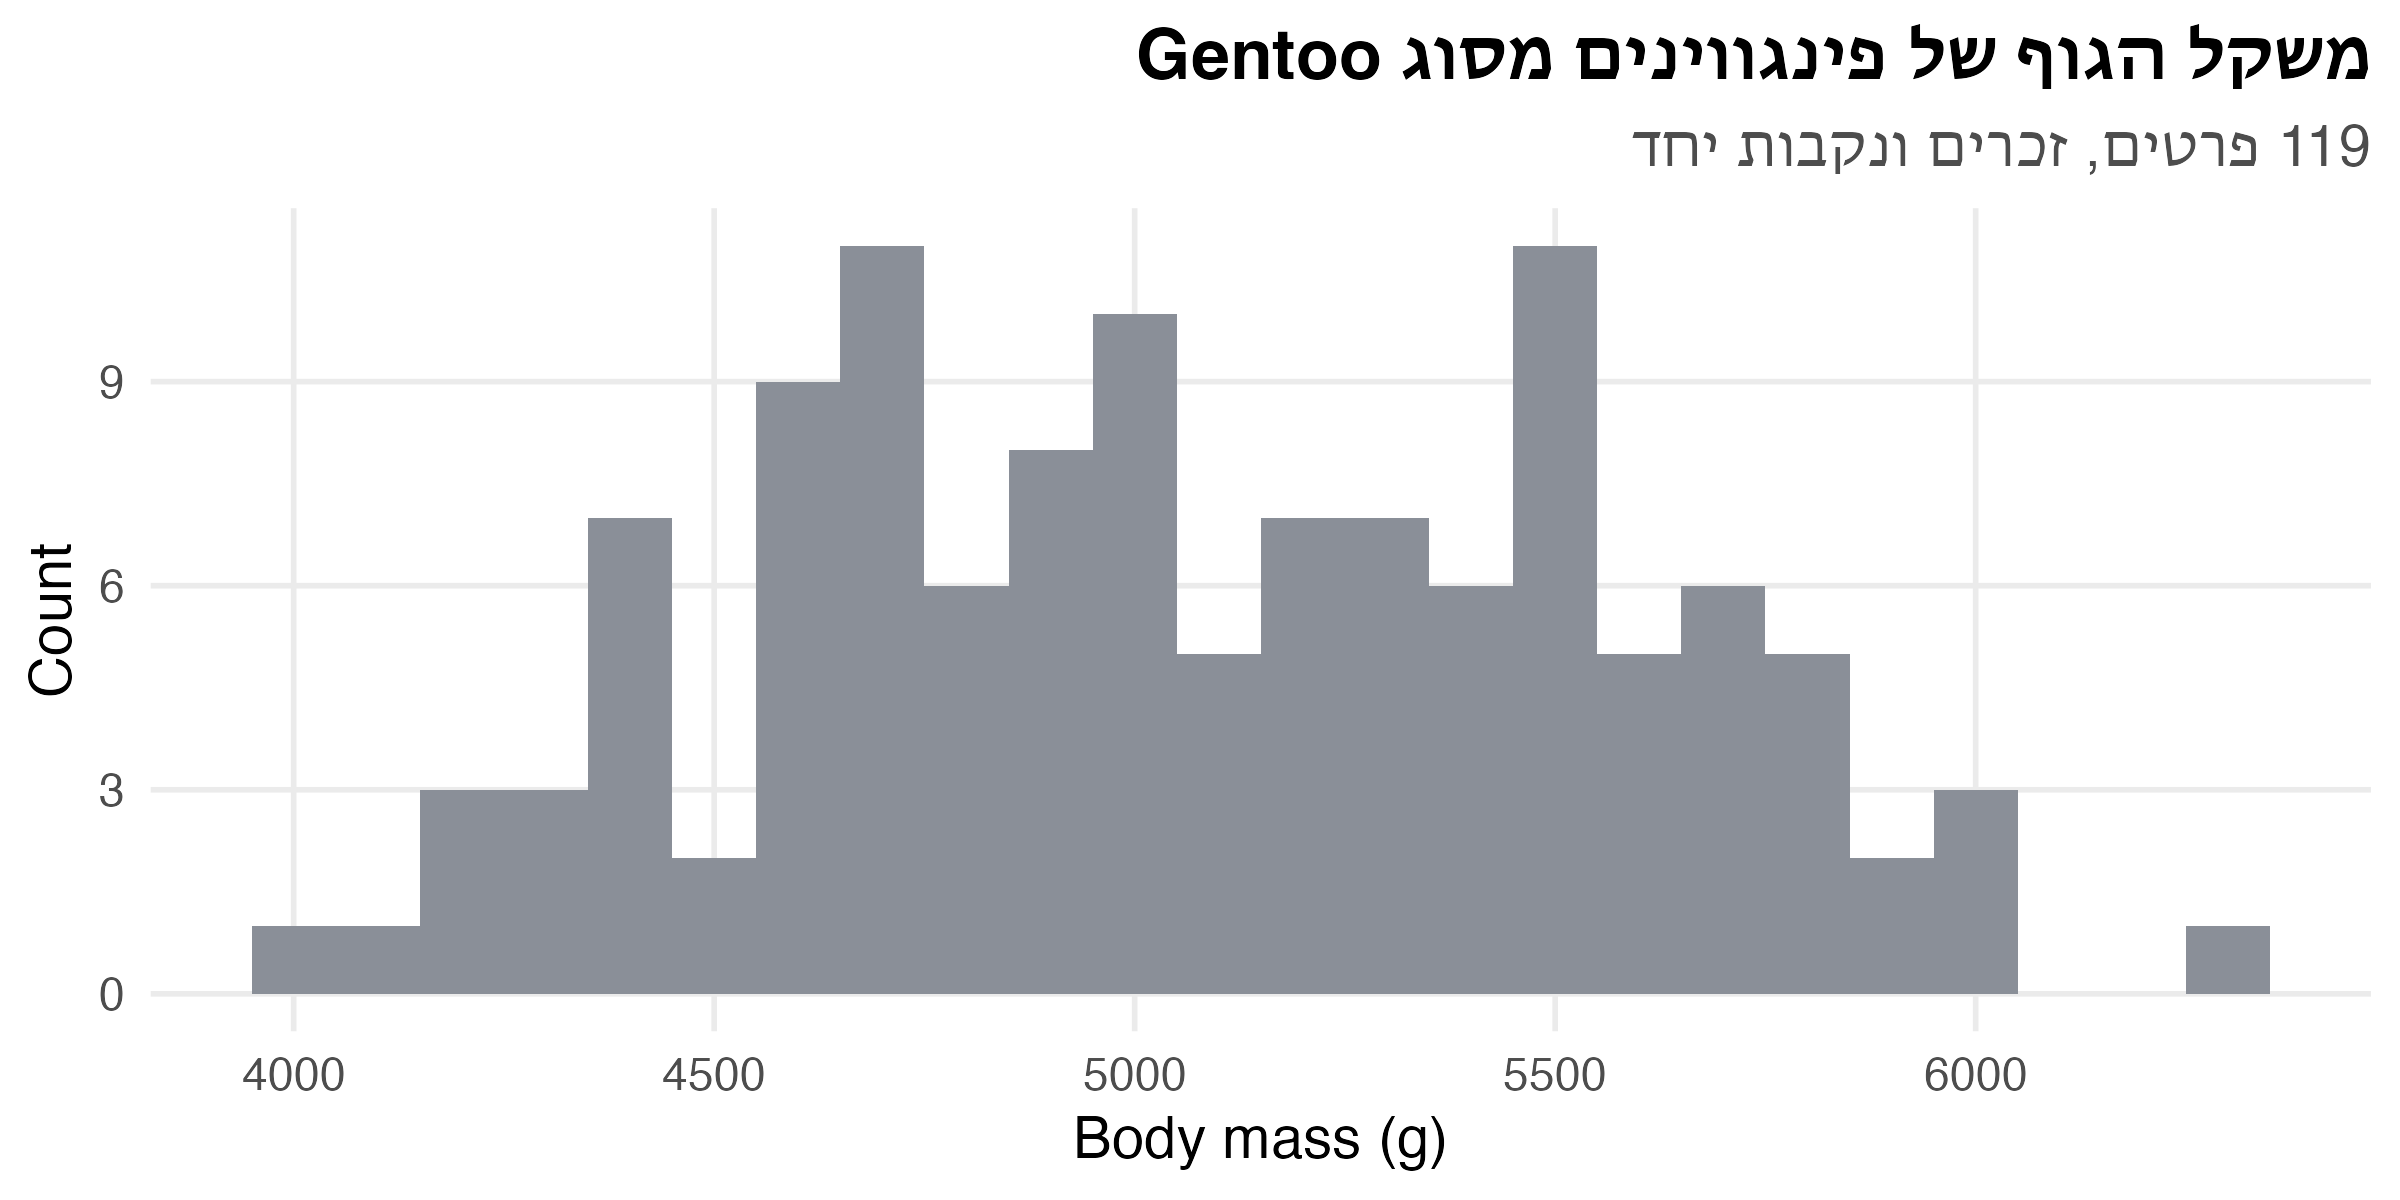
gentoo <- penguins |> filter(species == "Gentoo", !is.na(sex))
gentoo |> summarise(n = n(), mean = mean(body_mass), sd = sd(body_mass), .by = sex)
sex n mean sd
1 female 58 4680 281.6
2 male 61 5485 313.2ניתוח נתונים סטטיסטי · הרצאה 1
2026-10-19
sex_means <- gentoo |> summarise(mean = mean(body_mass), .by = sex)

ggplot(gentoo, aes(body_mass, fill = sex)) +
  geom_histogram(binwidth = 100, alpha = 0.6, position = "identity") +
  geom_vline(aes(xintercept = mean, colour = sex), data = sex_means,
             linetype = "dashed", linewidth = 0.9, show.legend = FALSE) +
  scale_fill_manual(values = c(female = nanas_pal[["accent"]], male = nanas_pal[["primary"]])) +
  scale_colour_manual(values = c(female = nanas_pal[["accent"]], male = nanas_pal[["primary"]])) +
  labs(title = "הזכרים כבדים בכ-800 גרם בממוצע",
       subtitle = "הקווים המקווקווים: הממוצע בכל קבוצה",
       x = "Body mass (g)", y = "Count", fill = NULL)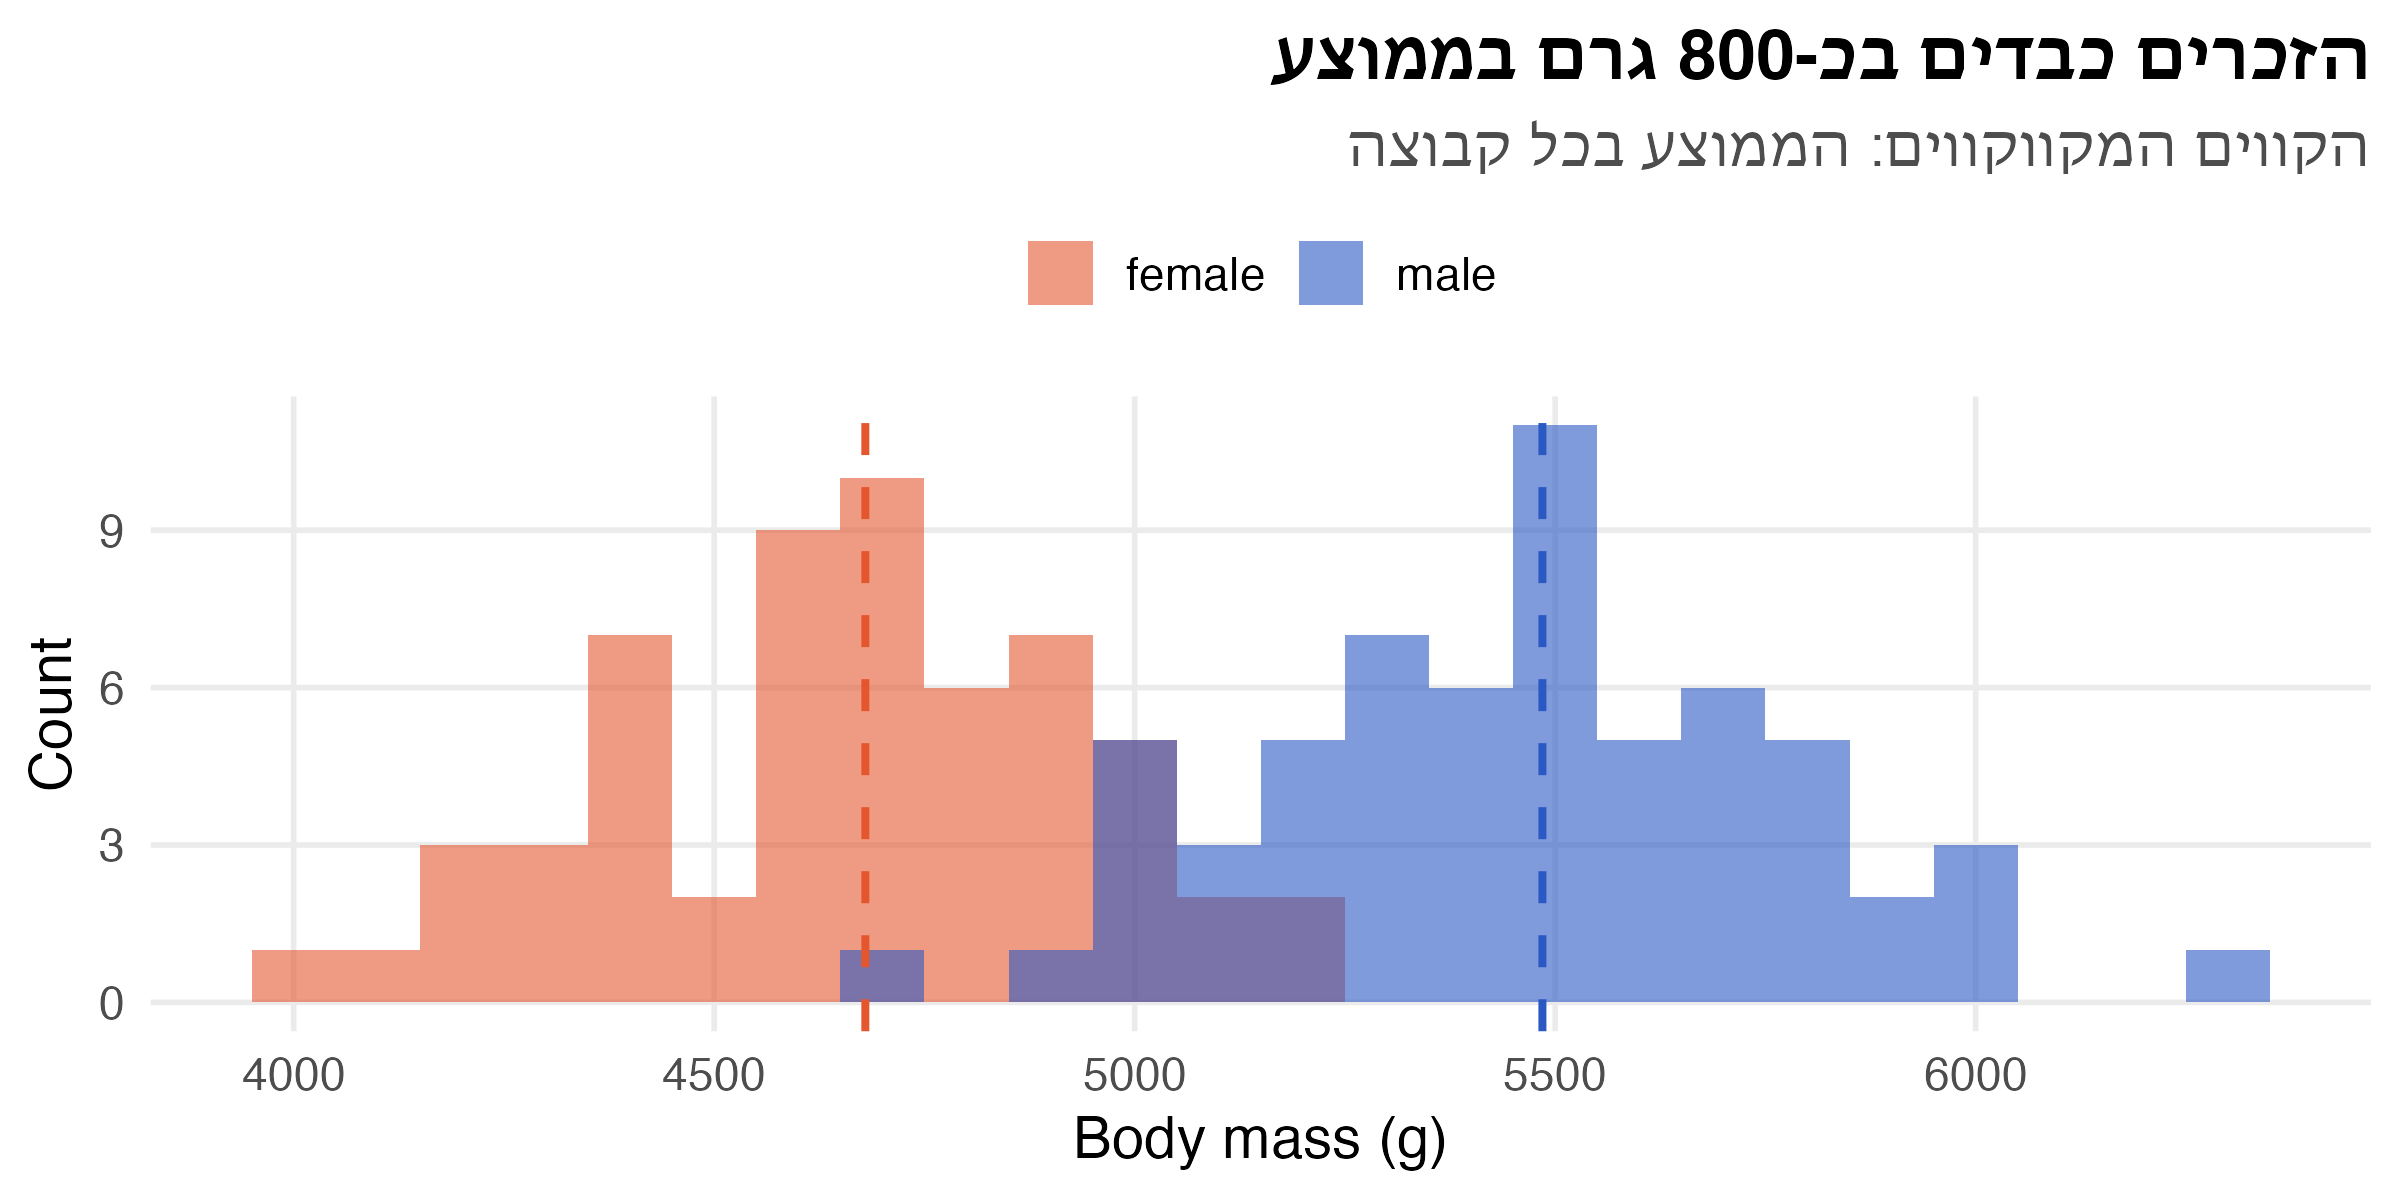
\[ H_0: \mu_F = \mu_M \qquad H_1: \mu_F \neq \mu_M \]
\[ t = \frac{\bar{x}_F - \bar{x}_M}{\sqrt{\dfrac{s_F^2}{n_F} + \dfrac{s_M^2}{n_M}}} = \frac{4679.7 - 5484.8}{\sqrt{\dfrac{281.6^2}{58} + \dfrac{313.2^2}{61}}} = \frac{-805.1}{54.5} \approx -14.76 \]
    Welch Two Sample t-test

data:  body_mass by sex
t = -14.76, df = 116.6, p-value <2e-16
alternative hypothesis: true difference in means between group female and group male is not equal to 0
95 percent confidence interval:
 -913.113 -697.076
sample estimates:
mean in group female   mean in group male
4679.74 5484.84 t = -14.76: ההפרש בין הממוצעים הוא כ-15 שגיאות תקן. הסימן שלילי כי R מחסר זכרים מנקבותdf = 116.6: Welch לא מניח שוויון שונויות, ולכן דרגות החופש לא שלמותp-value < 2e-16: אם \(H_0\) נכונה, הסיכוי לראות הפרש קיצוני כזה כמעט אפס. דוחים את \(H_0\)דוגמה:
\[ f(x) = \dfrac{1}{(1+x)^2}, \quad x \in [0, \infty) \]
\[ \mu = \int_0^\infty \frac{x}{(1+x)^2}\,dx = \infty \]
\[ F(a) = 1 - \frac{1}{1+a} = 0.5 \;\Rightarrow\; \tilde{\mu} = 1 \]
# F(x) = 1 - 1/(1+x)  =>  x = 1/(1-u) - 1
n <- 20000
heavy <- tibble(
  i = 1:n,
  x = 1 / (1 - runif(n)) - 1
) |>
  mutate(
    `ממוצע מצטבר` = cummean(x),
    `חציון מצטבר` = map_dbl(i, \(k) median(x[seq_len(k)]))
  ) |>
  filter(i %% 20 == 0) |>
  pivot_longer(c(`ממוצע מצטבר`, `חציון מצטבר`), names_to = "stat")

ggplot(heavy, aes(i, value, colour = stat)) +
  geom_hline(yintercept = 1, linetype = "dashed", colour = "grey50") +
  geom_line(linewidth = 0.8) +
  scale_x_log10(labels = label_comma()) +
  scale_colour_manual(values = c(nanas_pal[["accent"]], nanas_pal[["primary"]])) +
  labs(title = "החציון מתכנס ל-1, הממוצע ממשיך לטפס",
       subtitle = "דגימות מהתפלגות שבה התוחלת אינסופית",
       x = "Sample size (log scale)", y = NULL, colour = NULL)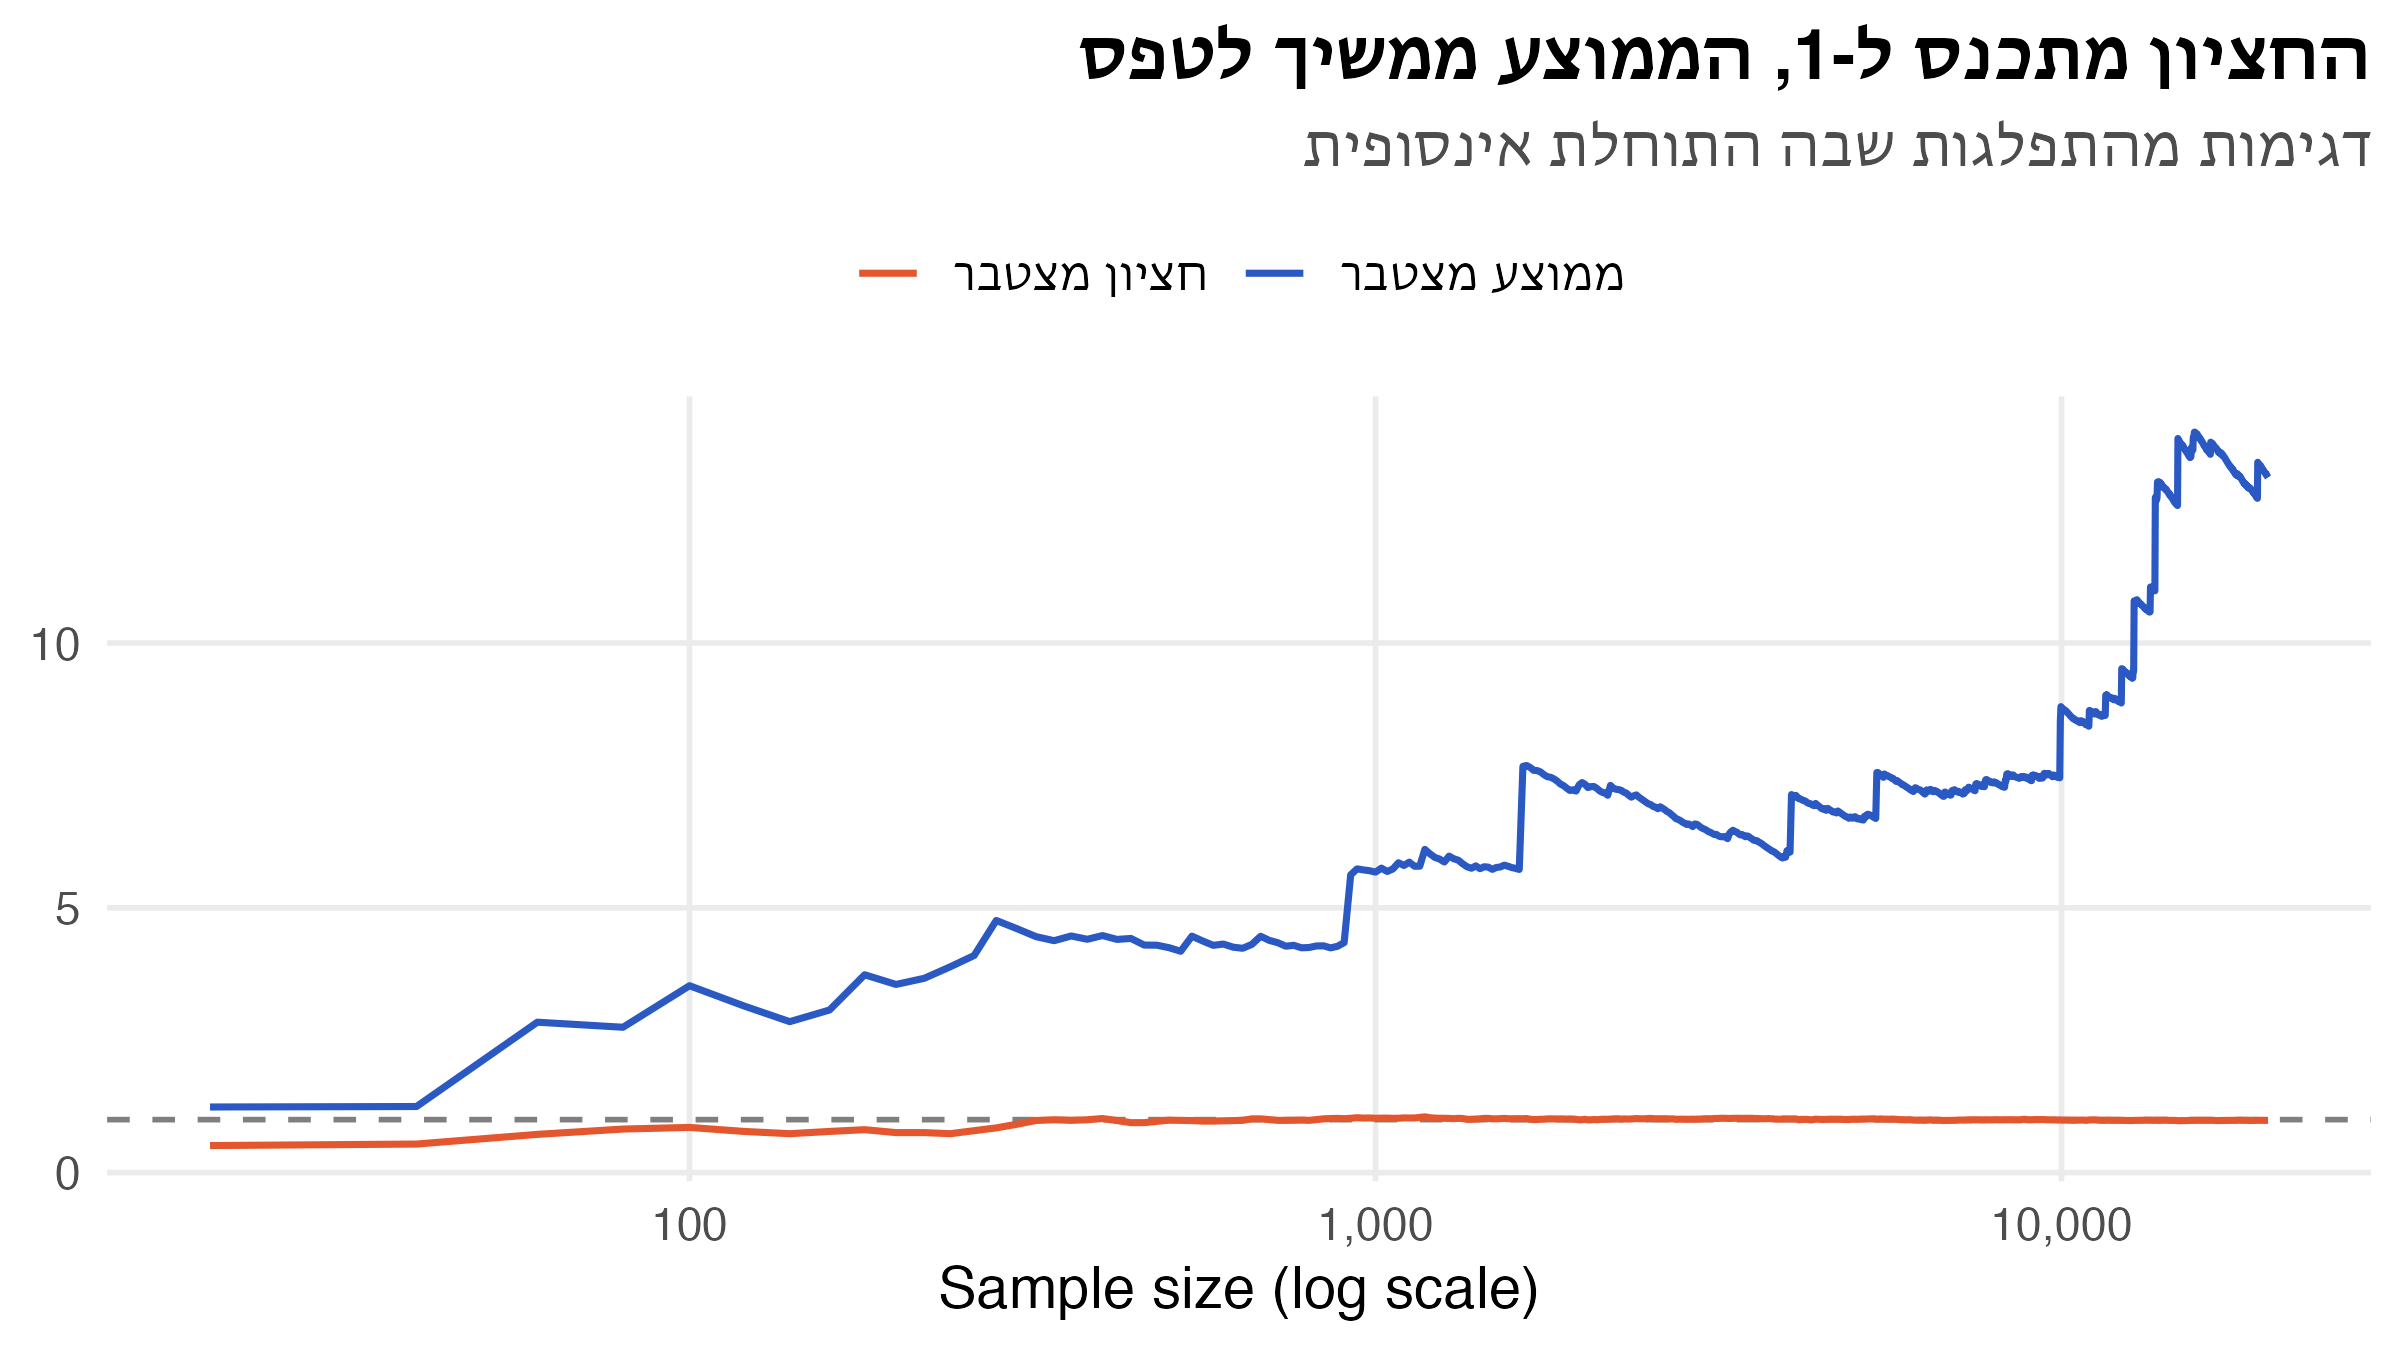
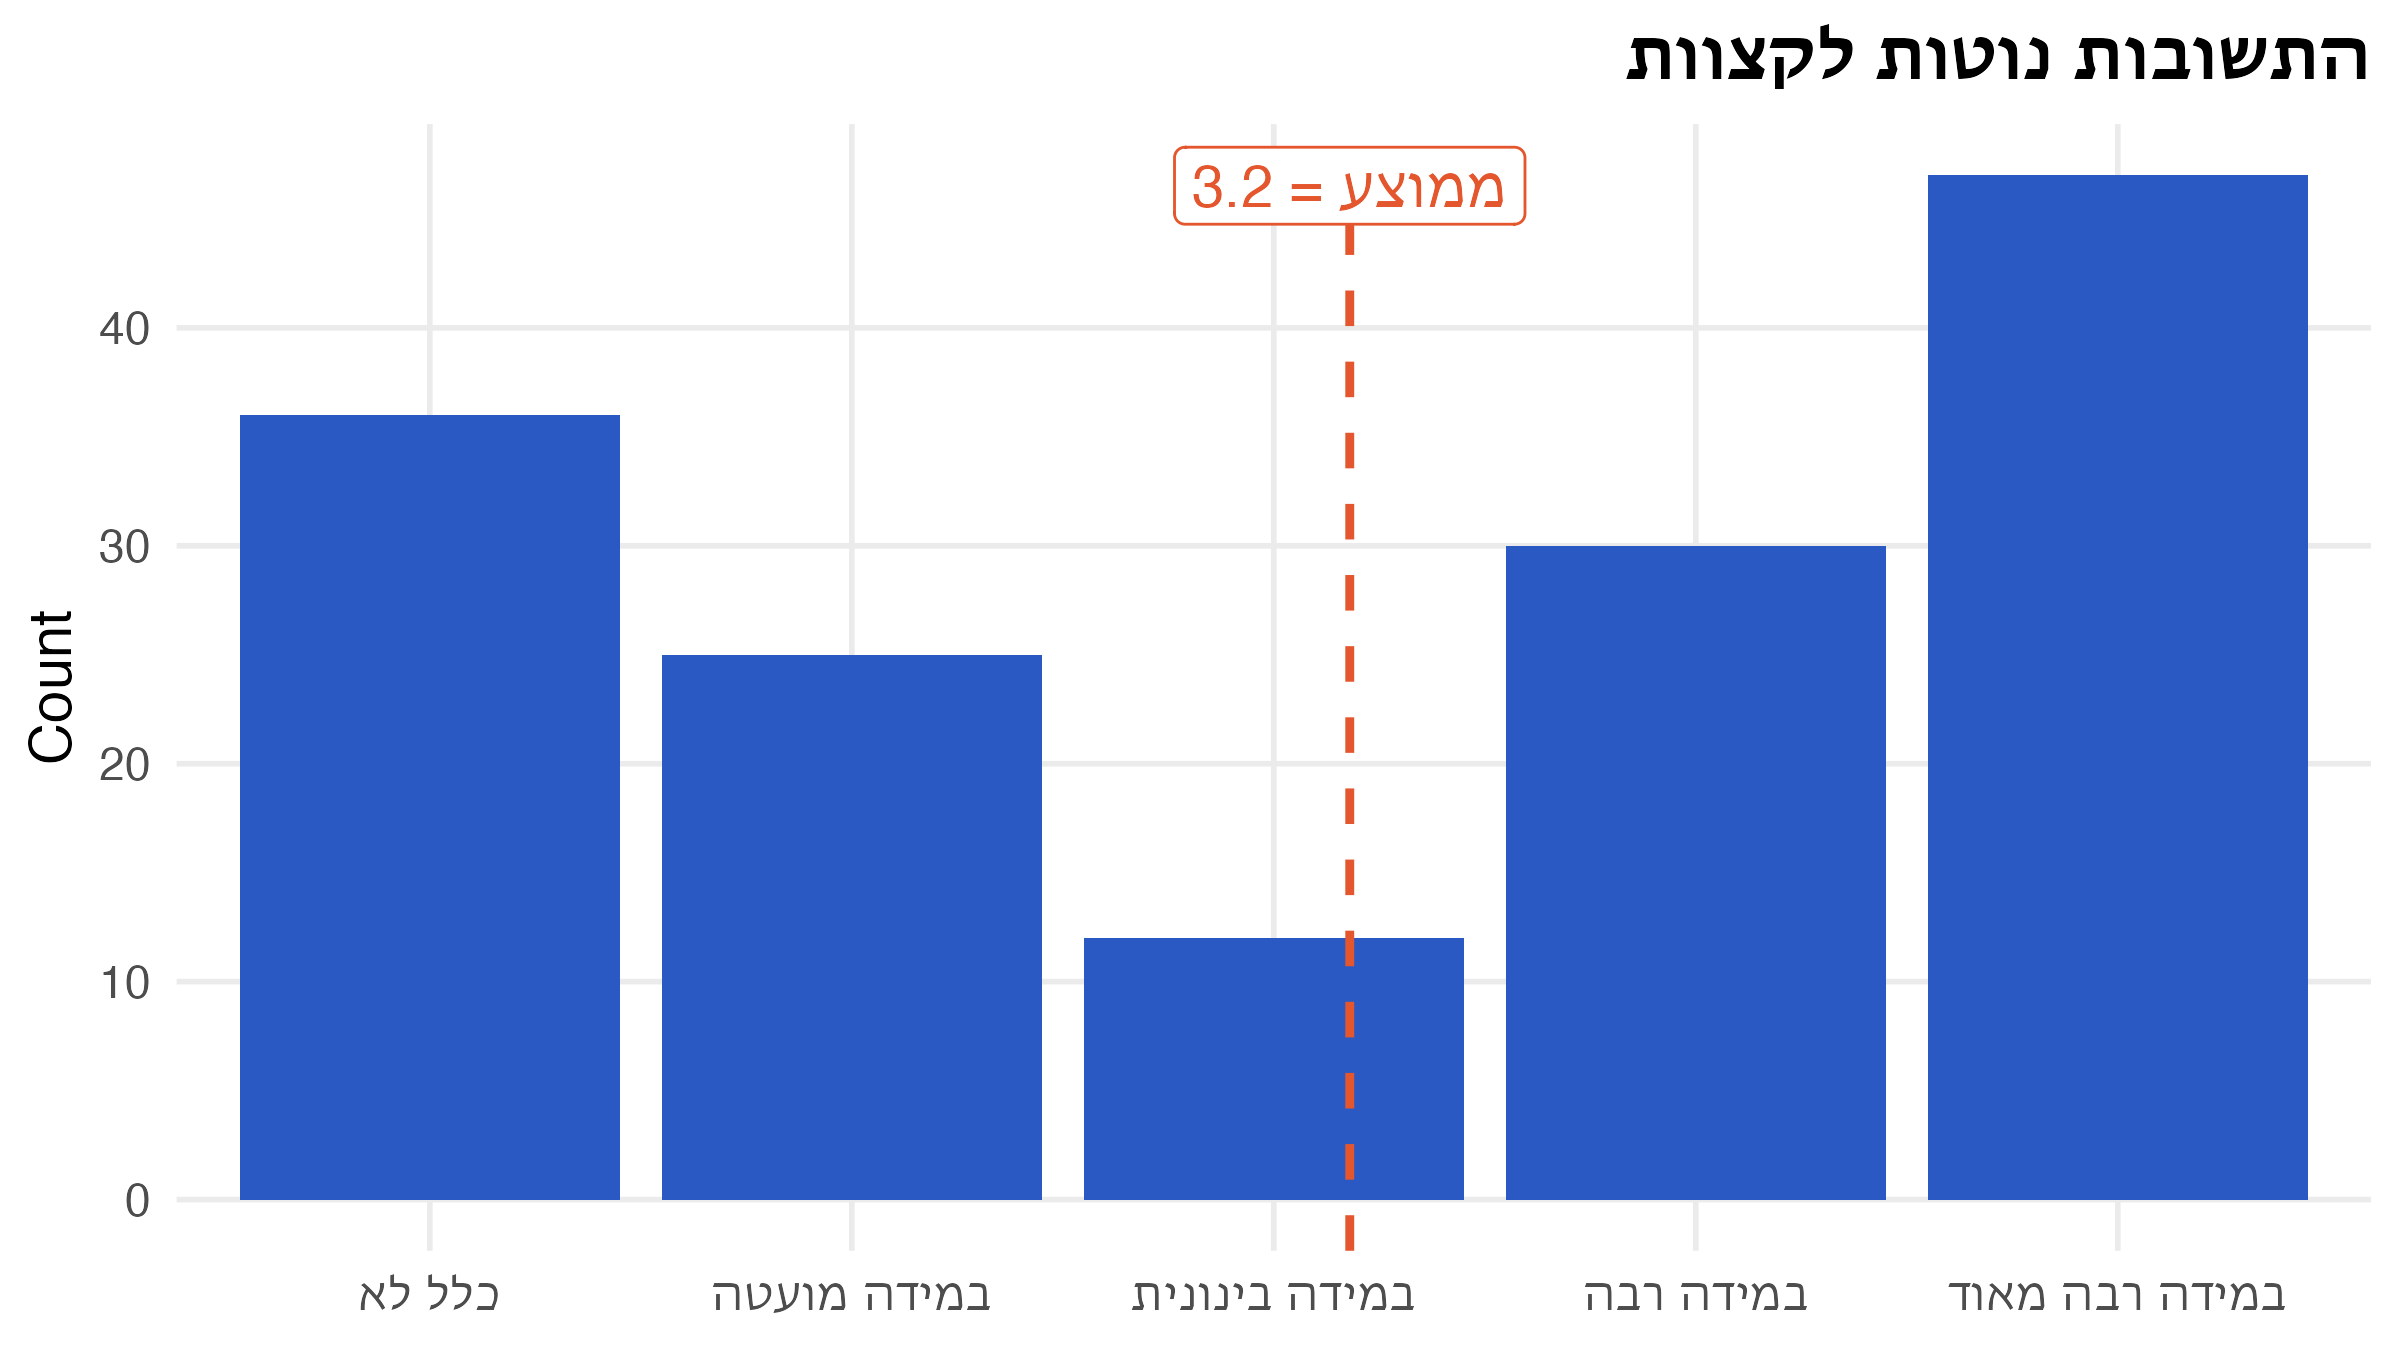
“באיזו מידה את/ה אוהב/ת סטטיסטיקה?” (150 משיבים)
| השאלה | השיטה הפרמטרית | השיטה הא-פרמטרית |
|---|---|---|
| מרכז ההתפלגות | מבחן t / Z על התוחלת | מבחן הסימן (Sign test), מבחן הדירוגים המסומנים (Wilcoxon signed-rank) |
| שני מדגמים מזווגים | מבחן t מזווג | מבחן הסימן / Wilcoxon signed-rank על ההפרשים |
| שתי אוכלוסיות בלתי תלויות | מבחן t לשני מדגמים | מבחן סכום הדירוגים (Mann–Whitney) |
| התאמה להתפלגות נתונה | מבחן חי-בריבוע לטיב התאמה (Goodness-of-fit), מבחן Kolmogorov–Smirnov | |
| השוואה בין שתי התפלגויות | מבחן חי-בריבוע להומוגניות (Chi-square test of homogeneity), Kolmogorov–Smirnov לשני מדגמים | |
| מתאם בין שני משתנים | מתאם פירסון | Spearman’s ρ, Kendall’s τ |
\[ H_0: \tilde{\mu} = z \qquad H_1: \tilde{\mu} \neq z \]
\[ r^+ \sim \text{Binomial}(n, 0.5) \qquad P(r \le y) = 2\,P(r^+ \le y), \quad y < n/2 \]
הערך הקריטי \(R^*_\alpha\) הוא הערך הגדול ביותר שמקיים
\[ P(r \le R^*_\alpha) = 2 \sum_{y=0}^{R^*_\alpha} \binom{n}{y}\left(\frac{1}{2}\right)^n \le \alpha \]
כלל ההכרעה: אם \(r_0 \le R^*_\alpha\), דוחים את \(H_0\).
ה-SLA של שירות קובע שהחציון של זמן התגובה הוא 200 ms. נדגמו 20 בקשות:
# A tibble: 2 × 2
  sign      n
  <chr> <int>
1 +        15
2 - 5ggplot(api, aes(latency_ms, 0, colour = latency_ms > 200)) +
geom_vline(xintercept = 200, linetype = "dashed", colour = "grey40") +
geom_point(size = 4, alpha = 0.8, position = position_jitter(height = 0.02, seed = 1)) +
scale_colour_manual(values = c(`FALSE` = nanas_pal[["accent"]], `TRUE` = nanas_pal[["primary"]]),
labels = c("מתחת ל-200", "מעל 200")) +
scale_y_continuous(NULL, breaks = NULL, limits = c(-0.1, 0.1)) +
labs(title = "15 מתוך 20 בקשות מעל 200 ms", x = "Latency (ms)", colour = NULL)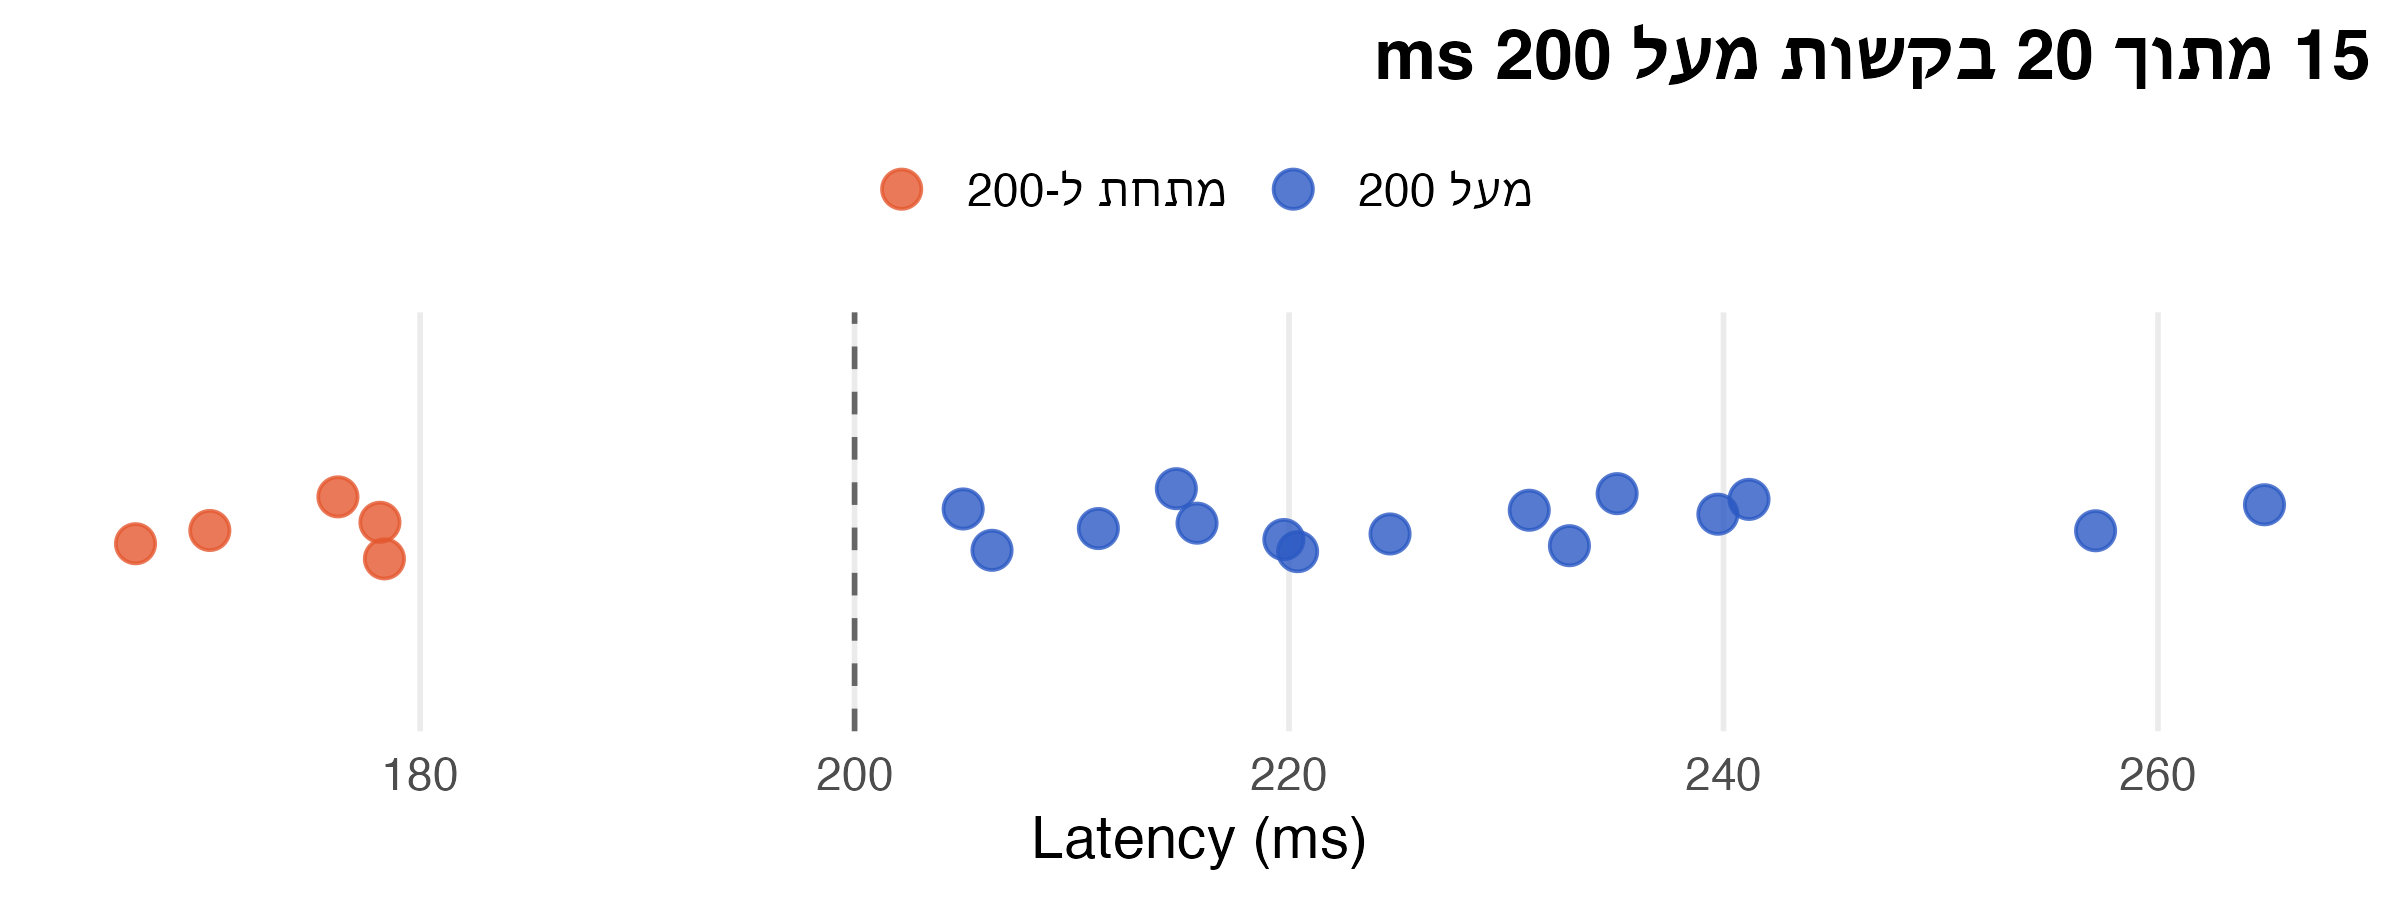
    Exact binomial test

data:  sum(api$latency_ms > 200) and nrow(api)
number of successes = 15, number of trials = 20, p-value = 0.04
alternative hypothesis: true probability of success is not equal to 0.5
95 percent confidence interval:
 0.5090 0.9134
sample estimates:
probability of success
0.75 מרצה טוען שחציון הציונים במועד ב׳ שלו הוא 80. ניגשו 11 סטודנטים. האם הטענה נכונה ב-\(\alpha = 0.1\)?
[1] 79 75 85 95 70 60 65 75 74 89 72[1] 0.2266כשהתצפיות מזווגות, מריצים את מבחן הסימן על ההפרשים \(d_i = x_i - y_i\), עם \(H_0: \tilde{\mu}_d = 0\).
דוגמה: צוות מוצר שוקל להחליף את Sonnet 5.5 ב-Opus 5.5, היקר יותר, למשימות תיוג. שני המודלים תייגו את אותן 11 משימות. האם Opus טועה פחות? בטבלה: שיעור השגיאות (%) בכל משימה. \(d_i\) = Opus פחות Sonnet. (נתונים מדומים)
| task | sonnet | opus | sign |
|---|---|---|---|
| ניתוב פניות שירות | 8.4 | 6.9 | - |
| סנטימנט בביקורות | 4.1 | 3.6 | - |
| זיהוי ספאם | 2.3 | 2.1 | - |
| זיהוי כוונה בצ׳אט | 11.2 | 9.0 | - |
| זיהוי תוכן פוגעני | 6.5 | 12.4 | + |
| שדות בחשבוניות | 9.8 | 8.1 | - |
| זיהוי שפה | 1.4 | 0.6 | - |
| תעדוף פניות רפואיות | 14.7 | 11.6 | - |
| סיווג סעיפים בחוזים | 13.0 | 10.4 | - |
| קטגוריית מוצר | 7.2 | 6.0 | - |
| זיהוי סרקזם | 15.3 | 22.1 | + |
    Exact binomial test

data:  n_plus and nrow(llm_err)
number of successes = 2, number of trials = 11, p-value = 0.0654
alternative hypothesis: true probability of success is not equal to 0.5
95 percent confidence interval:
 0.0228312 0.5177559
sample estimates:
probability of success
0.181818 \[ H_0: \tilde{\mu} = z \qquad H_1: \tilde{\mu} \neq z \]
\[ E(R^+) = \frac{n(n+1)}{4} \qquad V(R^+) = \frac{n(n+1)(2n+1)}{24} \]
דוגמה: \(z = 200\)
| \(x_i\) | \(x_i - z\) | \(\lvert x_i - z \rvert\) | דרגה מסומנת |
|---|---|---|---|
| 205 | \(+5\) | 5 | \(+2\) |
| 188 | \(-12\) | 12 | \(-4.5\) |
| 200 | \(0\) | נשמט | |
| 212 | \(+12\) | 12 | \(+4.5\) |
| 196 | \(-4\) | 4 | \(-1\) |
| 230 | \(+30\) | 30 | \(+6\) |
| 191 | \(-9\) | 9 | \(-3\) |
\(n = 6,\;\; R^+ = 12.5,\;\; R^- = 8.5\)
\(R = \min(R^+, R^-) = 8.5\)
בדיקה: \(R^+ + R^- = \frac{6 \cdot 7}{2} = 21\)
תחת \(H_0\) ההתפלגות סימטרית סביב \(z\), ולכן לכל הפרש יש סיכוי \(\frac{1}{2}\) להיות חיובי, בלי קשר לגודלו. אפשר לחשוב על זה כך: הדרגות \(1, 2, \dots, n\) קבועות, ולכל דרגה מטילים מטבע הוגן שקובע את הסימן שלה.
\[ R^+ = \sum_{k=1}^{n} k \cdot I_k, \qquad I_k \sim \text{Bernoulli}\left(\tfrac{1}{2}\right) \text{ בלתי תלויים} \]
\[ E(R^+) = \sum_{k=1}^{n} k \cdot \tfrac{1}{2} = \frac{1}{2} \cdot \frac{n(n+1)}{2} = \frac{n(n+1)}{4} \]
\[ V(R^+) = \sum_{k=1}^{n} k^2 \cdot \tfrac{1}{4} = \frac{1}{4} \cdot \frac{n(n+1)(2n+1)}{6} = \frac{n(n+1)(2n+1)}{24} \]
# A tibble: 1 × 2
  R_plus R_minus
   <dbl>   <dbl>
1   156.    53.5
\[ R = \min(156.5,\; 53.5) = 53.5 < 60 = R^*_{0.1,\,20} \]
ולכן דוחים את \(H_0\) ב-\(\alpha = 0.1\).
    Wilcoxon signed rank test with continuity correction

data:  api$latency_ms
V = 156, p-value = 0.06
alternative hypothesis: true location is not equal to 200
V ב-R הוא \(R^+\) (156.5), לא \(\min(R^+, R^-)\)exact = FALSE: יש דרגות זהות, ולכן R משתמש בקירוב הנורמלינחזור ל-Sonnet מול Opus:
       sign signed_rank
0.06543 0.32031 \[ E(T) = \frac{m(n+m+1)}{2} \qquad V(T) = \frac{mn(n+m+1)}{12} \]
דוחים את \(H_0\) אם \(\left|\frac{T - E(T)}{\sigma_T}\right| > Z_{1-\alpha/2}\)
נניח שאין תיקו. נסמן ב-\(R_1, \dots, R_m\) את הדרגות של תצפיות המדגם הקטן, כך ש-\(T = \sum_{i=1}^{m} R_i\).
תחת \(H_0\) כל התצפיות מגיעות מאותה התפלגות, ולכן כל סידור של \(N\) התצפיות סביר באותה מידה. מכאן שכל דרגה \(R_i\) מתפלגת אחיד על \(\{1, 2, \dots, N\}\):
\[ E(R_i) = \frac{1}{N}\sum_{k=1}^{N} k = \frac{N+1}{2} \]
התוחלת לינארית, ולכן (בלי צורך באי-תלות):
\[ E(T) = \sum_{i=1}^{m} E(R_i) = m \cdot \frac{N+1}{2} = \frac{m(n+m+1)}{2} \]
ובאותה דרך נקבל גם את השונות של דרגה בודדת:
\[ V(R_i) = E(R_i^2) - E(R_i)^2 = \frac{(N+1)(2N+1)}{6} - \frac{(N+1)^2}{4} = \frac{N^2 - 1}{12} \]
הדרגות תלויות: שתי תצפיות לא יכולות לקבל אותה דרגה. לכן צריך גם את השונות המשותפת:
\[ V(T) = \sum_{i=1}^{m} V(R_i) + \sum_{i \neq j} \text{Cov}(R_i, R_j) = m\,\sigma^2 + m(m-1)\,c \]
כאשר \(\sigma^2 = \frac{N^2-1}{12}\) ו-\(c = \text{Cov}(R_i, R_j)\) (זהה לכל זוג, מסימטריה).
הטריק: סכום כל \(N\) הדרגות הוא קבוע, \(1 + 2 + \dots + N\), ולכן השונות שלו אפס. אותו חישוב עם \(m = N\) נותן:
\[ 0 = N\sigma^2 + N(N-1)\,c \quad\Longrightarrow\quad c = -\frac{\sigma^2}{N-1} = -\frac{N+1}{12} \]
מציבים בחזרה:
\[ V(T) = m\sigma^2\left(1 - \frac{m-1}{N-1}\right) = m \cdot \frac{(N+1)(N-1)}{12} \cdot \frac{n}{N-1} = \frac{mn(n+m+1)}{12} \]
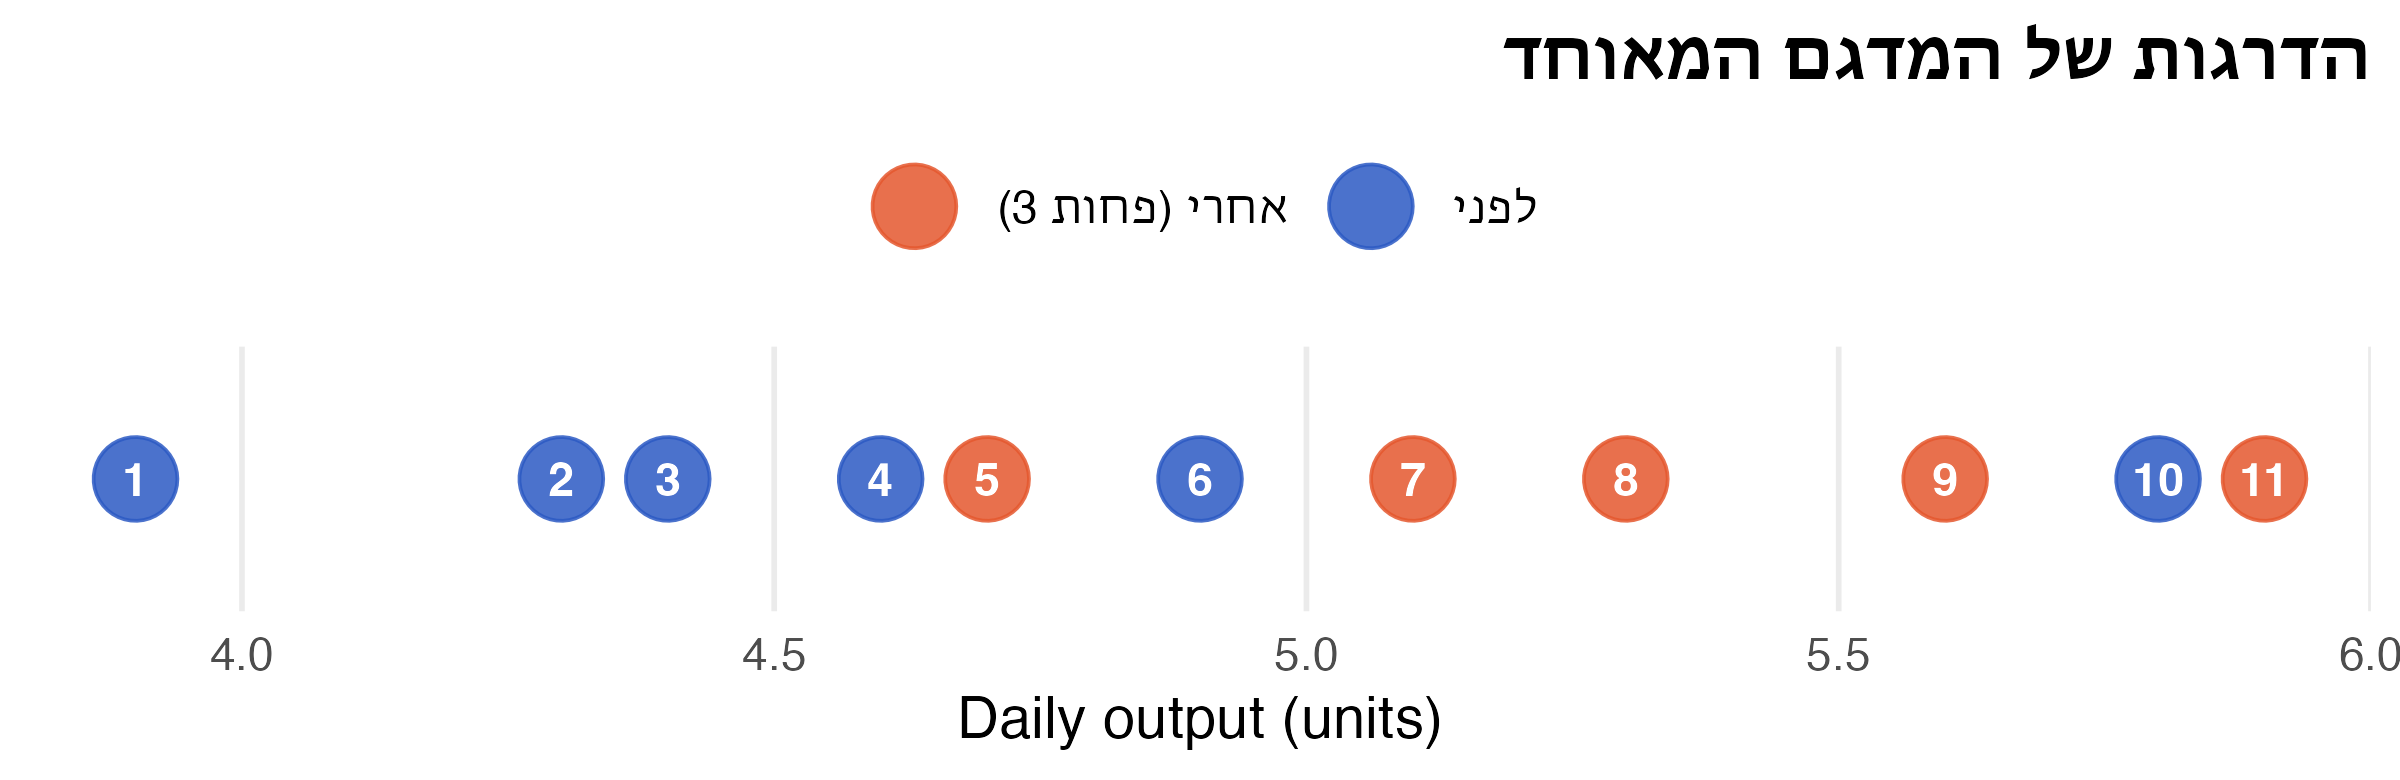
שיפור טכנולוגי בתהליך הייצור לא שינה את צורת ההתפלגות של התפוקה היומית, אבל הזיז אותה כלפי מעלה. האם התפוקה עלתה ב-3 יחידות ביום? (\(\alpha = 0.05\))
# A tibble: 2 × 2
  period units
  <chr>  <chr>
1 after  7.7, 8.1, 8.3, 8.6, 8.9
2 before 3.9, 4.3, 4.4, 4.6, 4.9, 5.8
הטריק: מורידים 3 מהתצפיות שאחרי השיפור. אם התפוקה עלתה ב-3 בדיוק, שני המדגמים מגיעים מאותה התפלגות.
prod_shift <- prod |>
  mutate(adj = if_else(period == "after", units - 3, units),
         rank = rank(adj))

ggplot(prod_shift, aes(adj, 0, colour = period, label = rank)) +
  geom_point(size = 9, alpha = 0.85) +
  geom_text(colour = "white", fontface = "bold", size = 4) +
  scale_colour_manual(values = c(after = nanas_pal[["accent"]], before = nanas_pal[["primary"]]),
                      labels = c(after = "אחרי (פחות 3)", before = "לפני")) +
  scale_y_continuous(NULL, breaks = NULL) +
  labs(title = "הדרגות של המדגם המאוחד", x = "Daily output (units)", colour = NULL)
\[ T_0 = 5 + 7 + 8 + 9 + 11 = 40, \quad E(T) = \tfrac{5 \cdot 12}{2} = 30, \quad V(T) = \tfrac{5 \cdot 6 \cdot 12}{12} = 30 \]
\[ \left|\frac{40 - 30}{\sqrt{30}}\right| = 1.82 < 1.96 \]
ולכן לא דוחים \(H_0\): הנתונים מתיישבים עם שיפור של 3 יחידות ביום.
    Wilcoxon rank sum exact test

data:  after and before
W = 25, p-value = 0.08
alternative hypothesis: true location shift is not equal to 3W הוא \(T - \frac{m(m+1)}{2} = 40 - 15 = 25\) (סטטיסטי Mann–Whitney U)mu = 3 בודק הזזה של 3 יחידות, בלי לחסר ידנית\(H_0\): ההסתברויות של \(k\) הקטגוריות הן \(p_1, \dots, p_k\). \(O_i\) הוא המספר שנצפה, \(E_i = n p_i\) המספר הצפוי:
\[ \chi^2 = \sum_{i=1}^{k} \frac{(O_i - E_i)^2}{E_i} \;\sim\; \chi^2_{k-1-m} \]
\(m\) הוא מספר הפרמטרים שאמדנו מהנתונים. זה מבחן א-פרמטרי: ההתפלגות של הסטטיסטי תחת \(H_0\) לא תלויה בהתפלגות של האוכלוסייה, ואותו מבחן עובד לכל \(F_0\). אבל ההתפלגות \(\chi^2\) היא רק קירוב למדגם גדול, שנשען על קירוב נורמלי לספירות. לכן צריך \(E_i \ge 5\) בכל קטגוריה. ב-KS, לעומת זאת, ההתפלגות של \(D\) תחת \(H_0\) מדויקת וזהה לכל \(F_0\) רציפה.
דוגמה: האם משקל הגוף של כל 342 הפינגווינים ב-Palmer Penguins (שלושת המינים יחד) מתפלג נורמלית? מחלקים ל-8 קטגוריות ששוות בהסתברותן תחת הנורמלית המותאמת, כך ש-\(E_i = 342/8 = 42.75\). אמדנו \(\mu\) ו-\(\sigma\), ולכן \(m = 2\).
X-squared
    33.86
\(\chi^2 = 33.86 > 11.07 = \chi^2_{0.95,\,5}\), ולכן דוחים \(H_0\): המשקל אינו נורמלי. זה תערובת של שלושה מינים.
כשהנתונים רציפים, החלוקה לקטגוריות מאבדת מידע. מבחן KS משווה את פונקציית ההתפלגות המצטברת:
\[ D = \max_x \left| F_n(x) - F_0(x) \right| \]
\[ D = \max_i \left\{ \frac{i}{n} - F_0(x_{(i)}),\;\; F_0(x_{(i)}) - \frac{i-1}{n} \right\} \]
נחזור למשקלי הפינגווינים, הפעם בלי לחלק לקטגוריות:
    Asymptotic one-sample Kolmogorov-Smirnov test

data:  mass
D = 0.1041, p-value = 0.00121
alternative hypothesis: two-sidedecdf_mass <- tibble(g = sort(unique(mass))) |> # g: each distinct weight
mutate(Fn = ecdf(mass)(g), F0 = pnorm(g, mean(mass), sd(mass)))
worst <- ecdf_mass |>
mutate(Fn_left = lag(Fn, default = 0), # the step's value just before g
Fn_end = if_else(abs(Fn - F0) >= abs(Fn_left - F0), Fn, Fn_left),
gap = abs(Fn_end - F0)) |>
slice_max(gap, n = 1, with_ties = FALSE)
ggplot(ecdf_mass, aes(g)) +
stat_function(fun = \(x) pnorm(x, mean(mass), sd(mass)),
colour = nanas_pal[["grey"]], linewidth = 1, linetype = "dashed") +
geom_step(aes(y = Fn), colour = nanas_pal[["primary"]], linewidth = 0.9) +
geom_segment(aes(x = g, xend = g, y = F0, yend = Fn_end), data = worst,
colour = nanas_pal[["accent"]], linewidth = 1.2) +
annotate("label", x = worst$g, y = (worst$F0 + worst$Fn_end) / 2,
label = paste0("D = ", round(worst$gap, 3)), hjust = -0.1, fill = "white") +
labs(title = "יותר מדי פינגווינים קלים",
subtitle = "כחול: התפלגות אמפירית · מקווקו: נורמלית עם אותו ממוצע וסטיית תקן",
x = "Body mass (g)", y = "F(x)")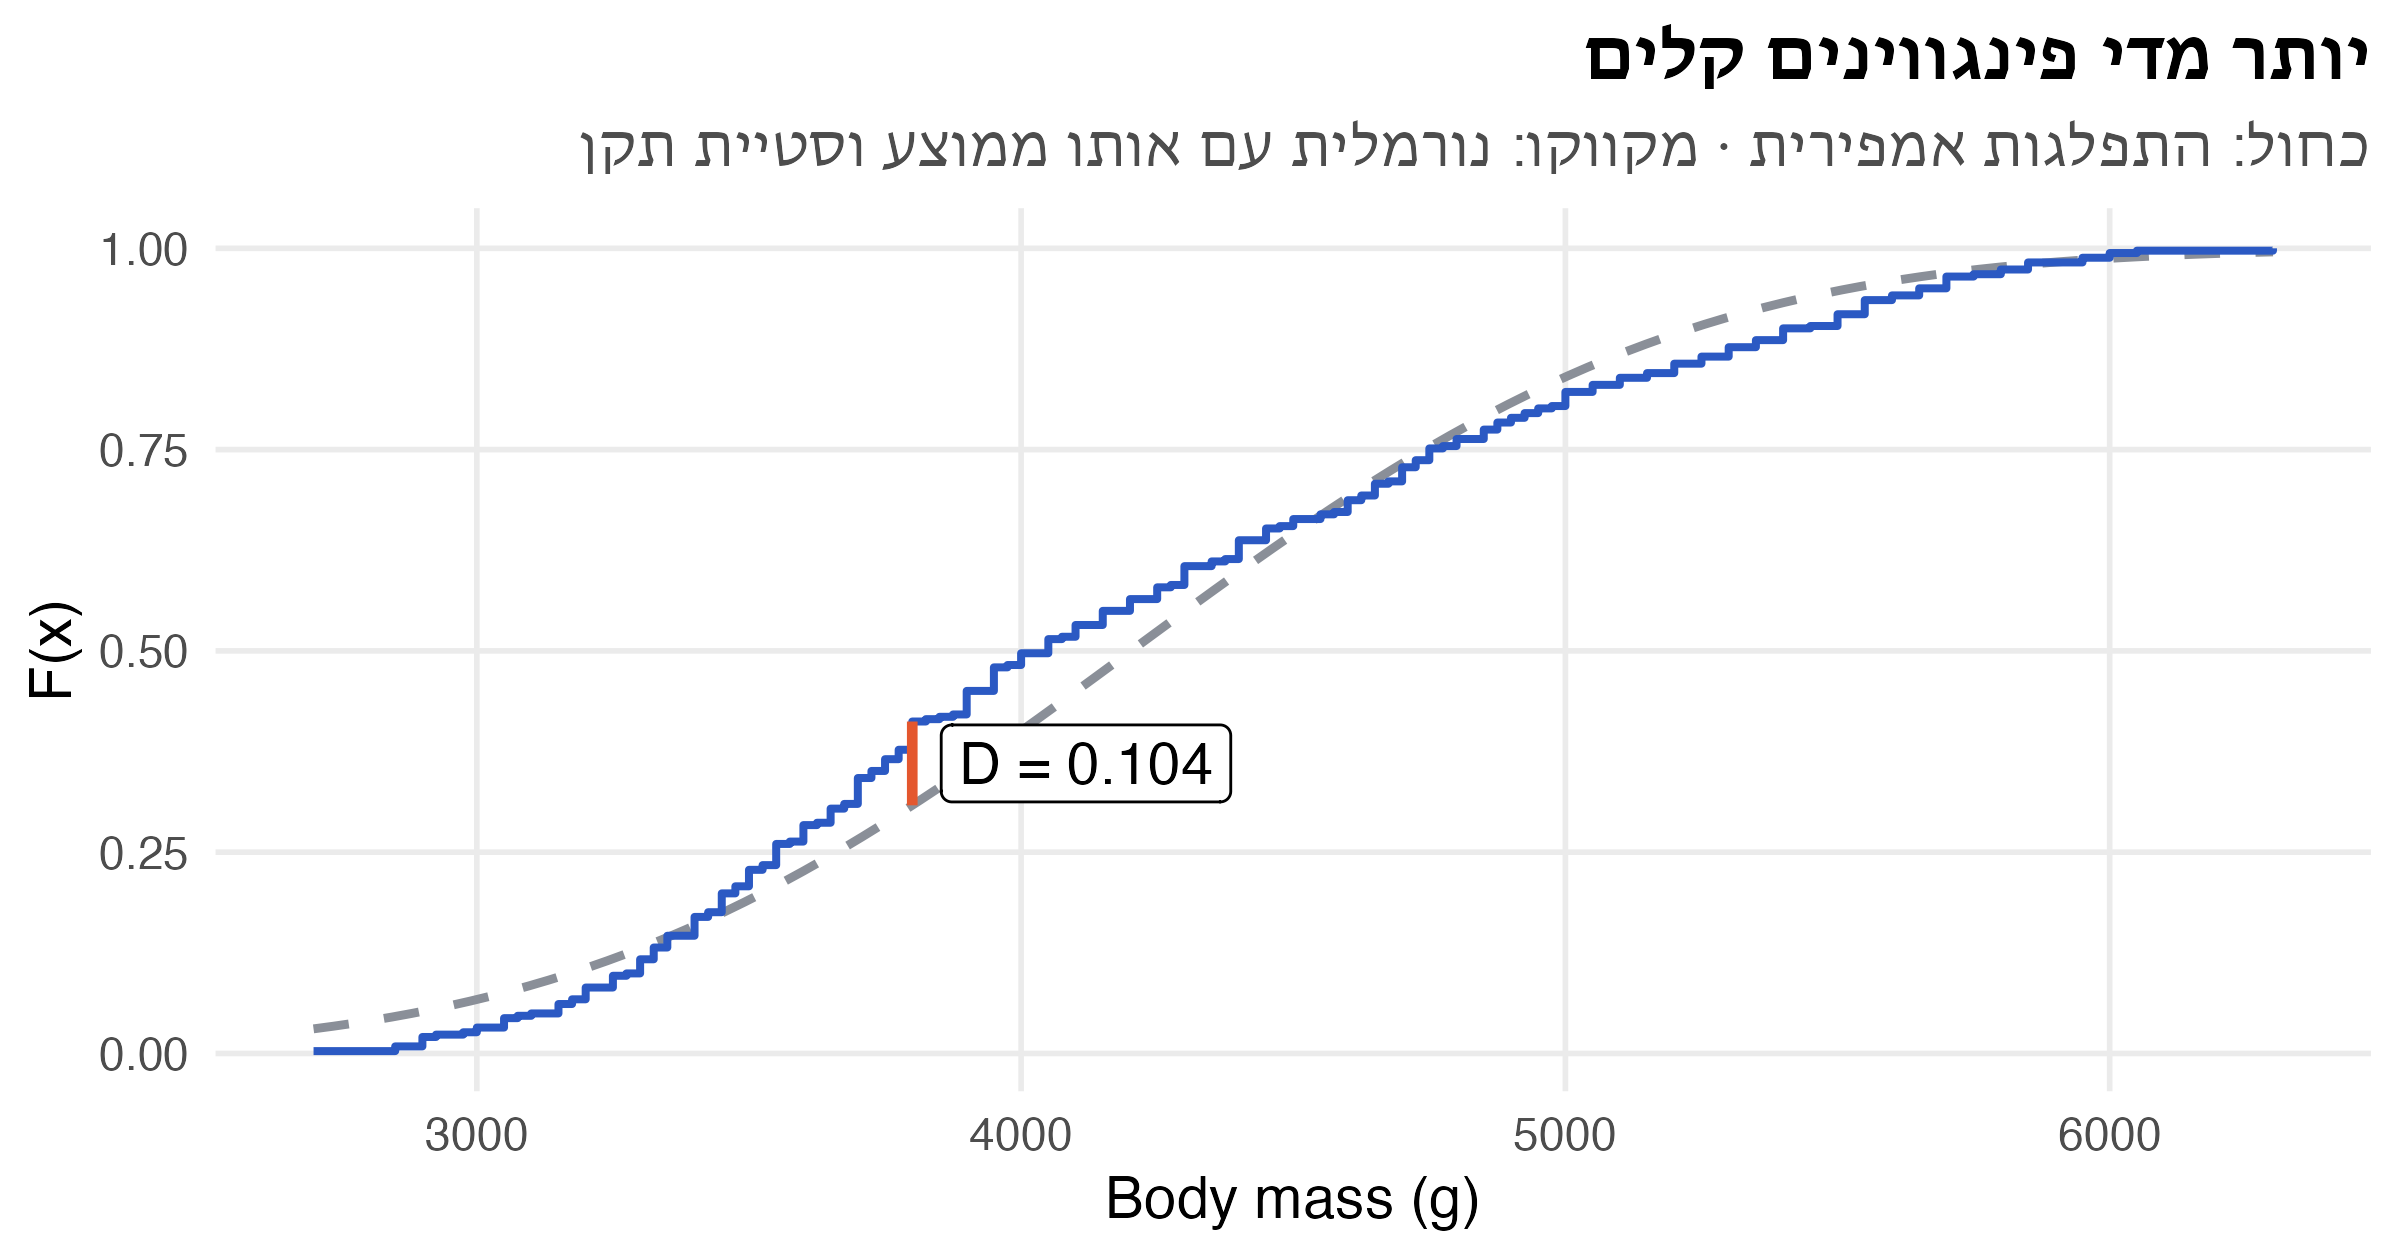
אותו רעיון, בלי \(F_0\): משווים בין שתי פונקציות התפלגות אמפיריות
\[ H_0: F_1(x) = F_2(x) \qquad D = \max_x \left| F_{1,n}(x) - F_{2,m}(x) \right| \]
דוגמה: גרסה חדשה של שירות inference עלתה לאוויר. החציון של זמן התגובה כמעט לא השתנה, אבל משתמשים מתלוננים על “קפיצות”. נדגמו 60 בקשות מכל גרסה. (נתונים מדומים)
# A tibble: 2 × 4
  version median   iqr   max
  <chr>    <dbl> <dbl> <dbl>
1 v1        227.  63.5  361.
2 v2 225. 180. 1048.grid <- tibble(ms = sort(latency$ms)) |>
mutate(v1 = ecdf(latency$ms[latency$version == "v1"])(ms),
v2 = ecdf(latency$ms[latency$version == "v2"])(ms),
gap = abs(v1 - v2))
max_gap <- slice_max(grid, gap, n = 1, with_ties = FALSE)
ggplot(latency, aes(ms, colour = version)) +
stat_ecdf(linewidth = 0.9) +
geom_segment(aes(x = ms, xend = ms, y = v1, yend = v2), data = max_gap,
colour = "grey20", linewidth = 1, inherit.aes = FALSE) +
annotate("label", x = max_gap$ms, y = (max_gap$v1 + max_gap$v2) / 2,
label = paste0("D = ", round(max_gap$gap, 2)), hjust = 1.1,
fill = "white", label.size = 0) +
scale_x_log10() +
scale_colour_manual(values = c(v1 = nanas_pal[["primary"]], v2 = nanas_pal[["accent"]])) +
labs(title = "אותו חציון, פיזור שונה לגמרי",
subtitle = "הקו השחור: המרחק הגדול ביותר בין שתי הפונקציות",
x = "Response time (ms, log scale)", y = "F(x)", colour = NULL)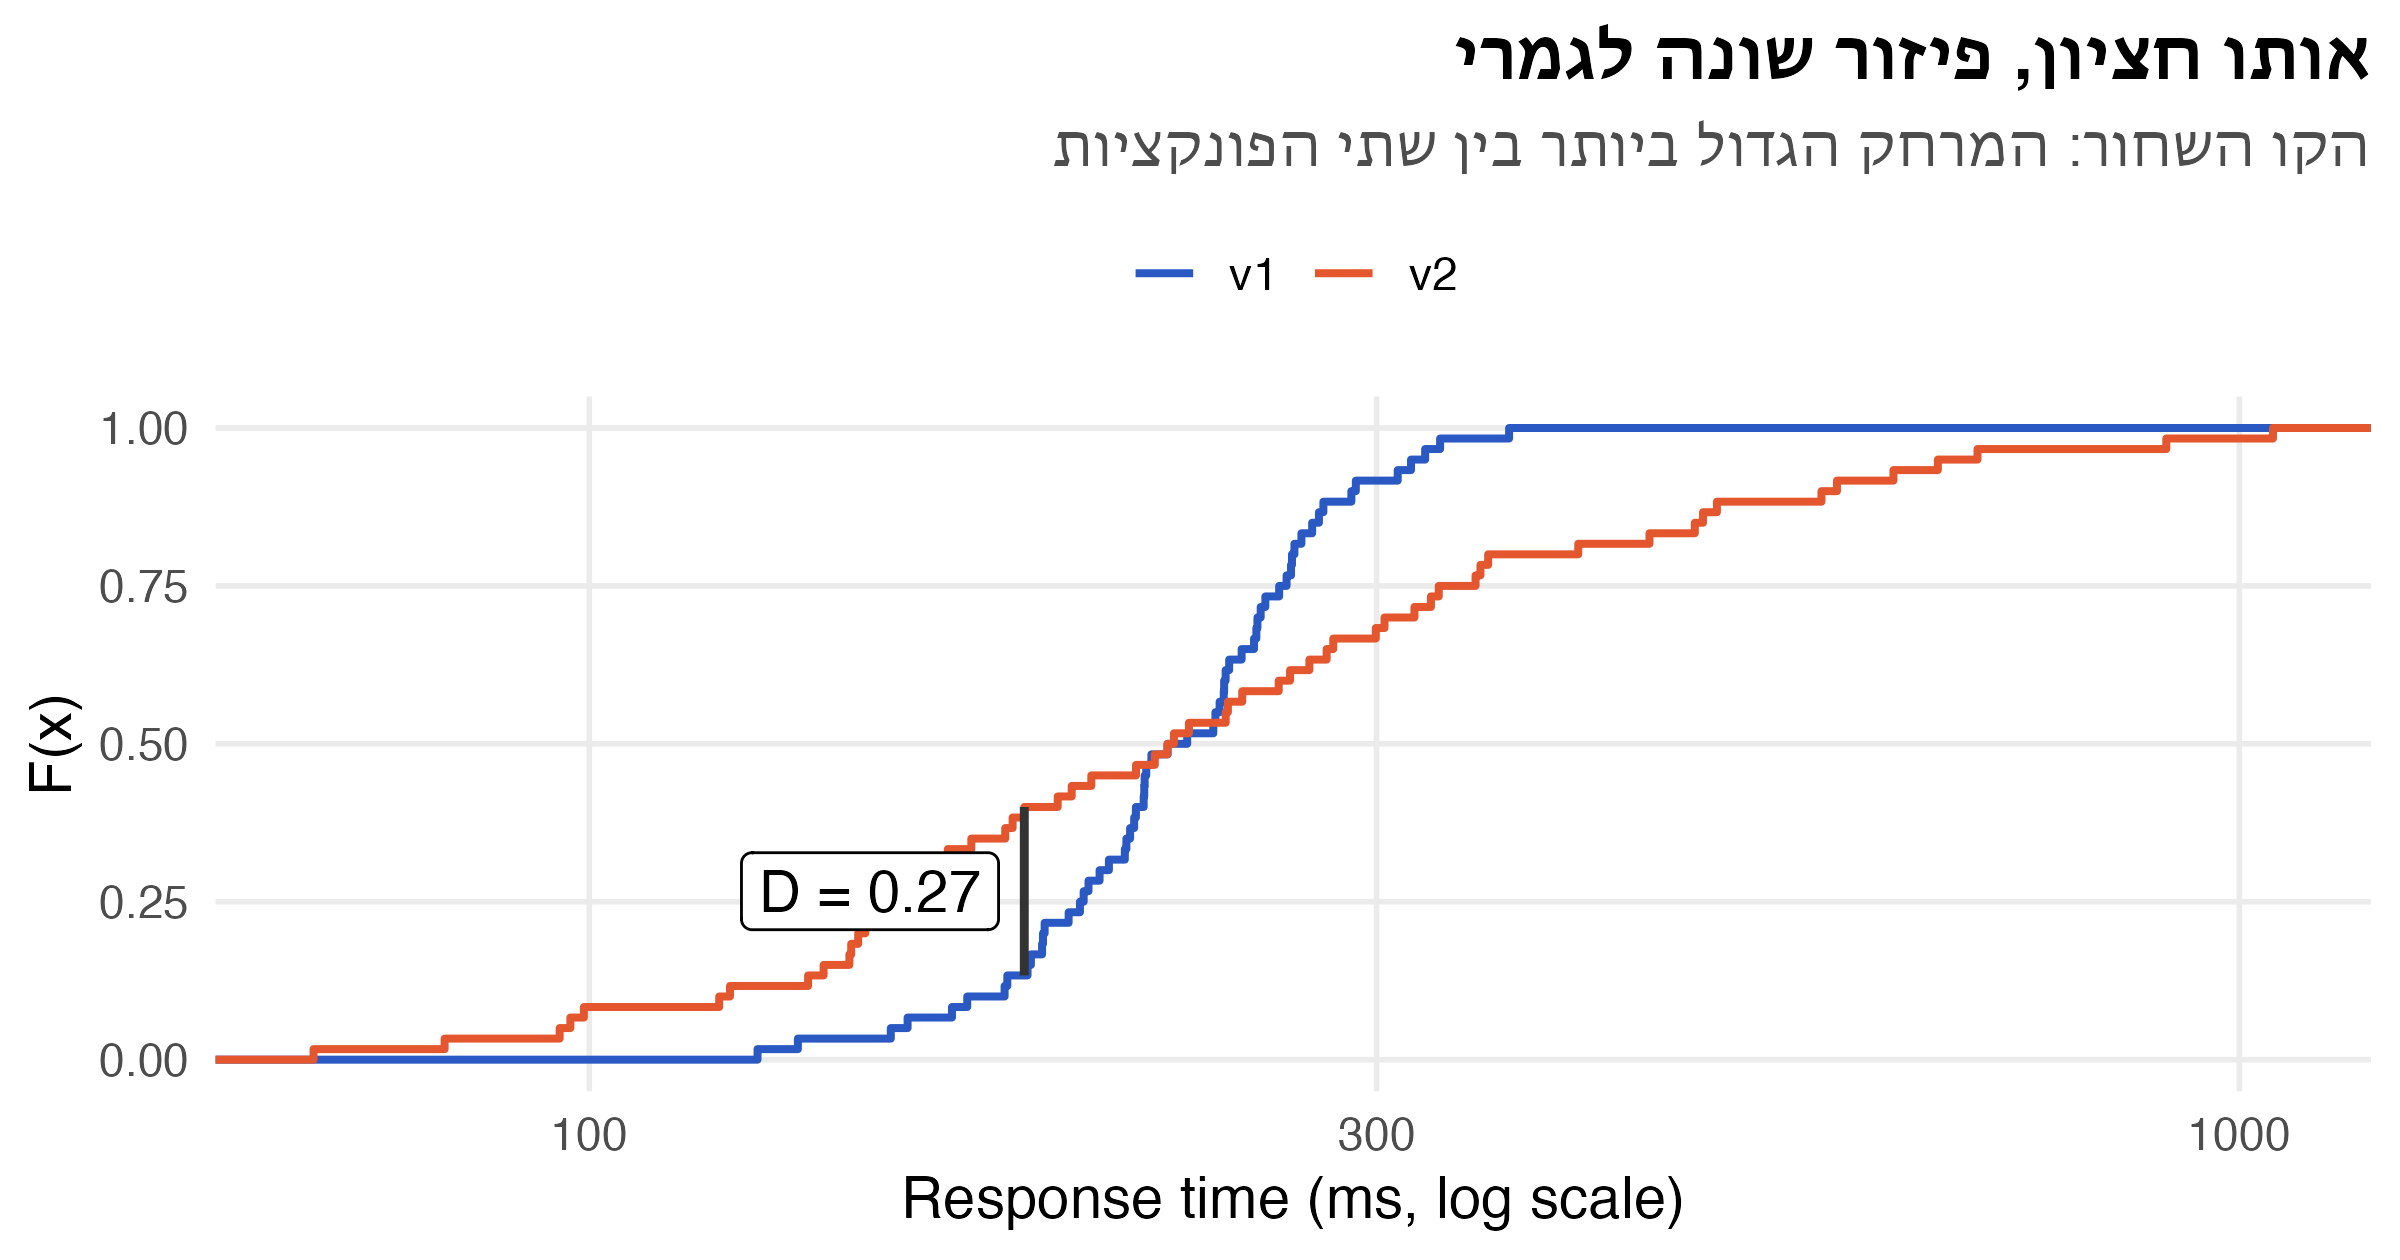
rank_sum       ks
0.95187 0.02763 גם חי-בריבוע יודע להשוות שתי התפלגויות (או יותר). מחלקים את שני המדגמים לאותן \(k\) קטגוריות ובונים טבלה של \(2 \times k\):
\[ H_0: F_1 = F_2 \qquad E_{ij} = \frac{\text{(סכום שורה } i) \cdot \text{(סכום עמודה } j)}{N} \qquad \chi^2 = \sum_{i,j} \frac{(O_{ij} - E_{ij})^2}{E_{ij}} \;\sim\; \chi^2_{(2-1)(k-1)} \]
אותם זמני תגובה, מחולקים ל-5 קטגוריות לפי החמישונים של המדגם המאוחד:
     [68.06,165.7] (165.7,212.3] (212.3,245.9] (245.9,300.4] (300.4,1048]
  v1             4            17            17            17            5
  v2            20             7             7             7           19
    Pearson's Chi-squared test

data:  tab
X-squared = 31, df = 4, p-value = 3e-06שני המבחנים א-פרמטריים: ההתפלגות של הסטטיסטי תחת \(H_0\) לא תלויה בהתפלגות של האוכלוסייה. ההבדל ביניהם הוא בסוג הנתונים ובמחיר:
| חי-בריבוע | KS | |
|---|---|---|
| נתונים | מחולקים לקטגוריות. מתאים גם לנתונים קטגוריים ובדידים | רציפים. משתמש בפונקציה האמפירית עצמה |
| מחיר | החלוקה לקטגוריות מאבדת מידע, והתוצאה תלויה בגבולות | דורש \(F_0\) רציפה ונתונה במלואה (אחרת Lilliefors) |
| קירוב | אסימפטוטי, צריך \(E_i \ge 5\) | יש טבלאות מדויקות גם למדגם קטן |
| שתי התפלגויות | מבחן הומוגניות, chisq.test(table(g, x)) |
KS לשני מדגמים, ks.test(x, y) |
\[ r = \frac{\sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y})}{\sqrt{\sum_{i=1}^{n} (x_i - \bar{x})^2 \, \sum_{i=1}^{n} (y_i - \bar{y})^2}} \]
כפי שראינו, פירסון מודד את חוזק הקשר הלינארי, אבל:
החלופה: מדדים שמבוססים על הדרגות, ולכן מודדים קשר מונוטוני, לא בהכרח לינארי.
זוג תצפיות \((x_i, y_i), (x_j, y_j)\) הוא בהתאמה (concordant) אם \(x_i > x_j\) וגם \(y_i > y_j\), או \(x_i < x_j\) וגם \(y_i < y_j\). אחרת הזוג בחוסר התאמה (discordant).
\[ \tau = \frac{n_c - n_d}{n_0}, \qquad n_0 = \binom{n}{2} \]
tau-b)שש תשובות של צ’אטבוט קיבלו ציון מבודק אנושי (\(X\)) ומשופט אוטומטי (LLM-as-judge, \(Y\)). האם השופט מדרג את התשובות באותו סדר כמו הבודק?
| תשובה | \(X\) | \(Y\) | \(R_X\) | \(R_Y\) | \(d_i\) | \(d_i^2\) |
|---|---|---|---|---|---|---|
| A | 3.1 | 52 | 1 | 2 | \(-1\) | 1 |
| B | 4.5 | 47 | 2 | 1 | \(+1\) | 1 |
| C | 5.2 | 61 | 3 | 4 | \(-1\) | 1 |
| D | 6.8 | 58 | 4 | 3 | \(+1\) | 1 |
| E | 7.4 | 74 | 5 | 6 | \(-1\) | 1 |
| F | 8.9 | 70 | 6 | 5 | \(+1\) | 1 |
| סה״כ | 6 |
\[ \rho_S = 1 - \frac{6 \sum d_i^2}{n(n^2 - 1)} \]
\[ \rho_S = 1 - \frac{6 \cdot 6}{6 \cdot 35} = 0.83 \]
אם השופט והבודק מדרגים בדיוק באותו סדר, כל \(d_i = 0\) ו-\(\rho_S = 1\)
אותן שש תשובות. עוברים על כל \(\binom{6}{2} = 15\) הזוגות. בכל זוג בודקים: האם השופט מסכים עם הבודק איזו מהשתיים טובה יותר?
| B | C | D | E | F | \(+\) | \(-\) | |
|---|---|---|---|---|---|---|---|
| A | \(-\) | \(+\) | \(+\) | \(+\) | \(+\) | 4 | 1 |
| B | \(+\) | \(+\) | \(+\) | \(+\) | 4 | 0 | |
| C | \(-\) | \(+\) | \(+\) | 2 | 1 | ||
| D | \(+\) | \(+\) | 2 | 0 | |||
| E | \(-\) | 0 | 1 | ||||
| סה״כ | 12 | 3 |
למשל, A מול B: הבודק העדיף את B, אבל השופט העדיף את A. הם לא מסכימים, ולכן הזוג בחוסר התאמה:
\[ X_B = 4.5 > 3.1 = X_A \qquad Y_A = 52 > 47 = Y_B \]
\[ n_c = 12, \qquad n_d = 3 \]
\[ \tau = \frac{n_c - n_d}{n_0} = \frac{12 - 3}{15} = 0.6 \]
פרשנות: \(\frac{1 + \tau}{2} = 0.8\), כלומר השופט והבודק מסכימים על הסדר ב-80% מהזוגות
set.seed(2026)   # own seed, so edits elsewhere in the lecture don't change this example
corr_data <- tibble(x = 1:30, y = exp(x / 6) + rnorm(30, sd = 1.5)) |>
  add_row(x = 2, y = 160)   # one data-entry error

stats <- c(
  pearson  = cor(corr_data$x, corr_data$y),
  spearman = cor(corr_data$x, corr_data$y, method = "spearman"),
  kendall  = cor(corr_data$x, corr_data$y, method = "kendall")
)   # shown in the chart title

ggplot(corr_data, aes(x, y)) +
  geom_point(size = 2.5) +
  annotate("label", x = 3.5, y = 160, label = "שגיאת הקלדה", hjust = 0) +
  labs(title = sprintf("Pearson = %.2f · Spearman = %.2f · Kendall = %.2f",
                       stats["pearson"], stats["spearman"], stats["kendall"]),
       subtitle = "קשר מונוטוני ברור, עם תצפית חריגה אחת",
       x = "x", y = "y")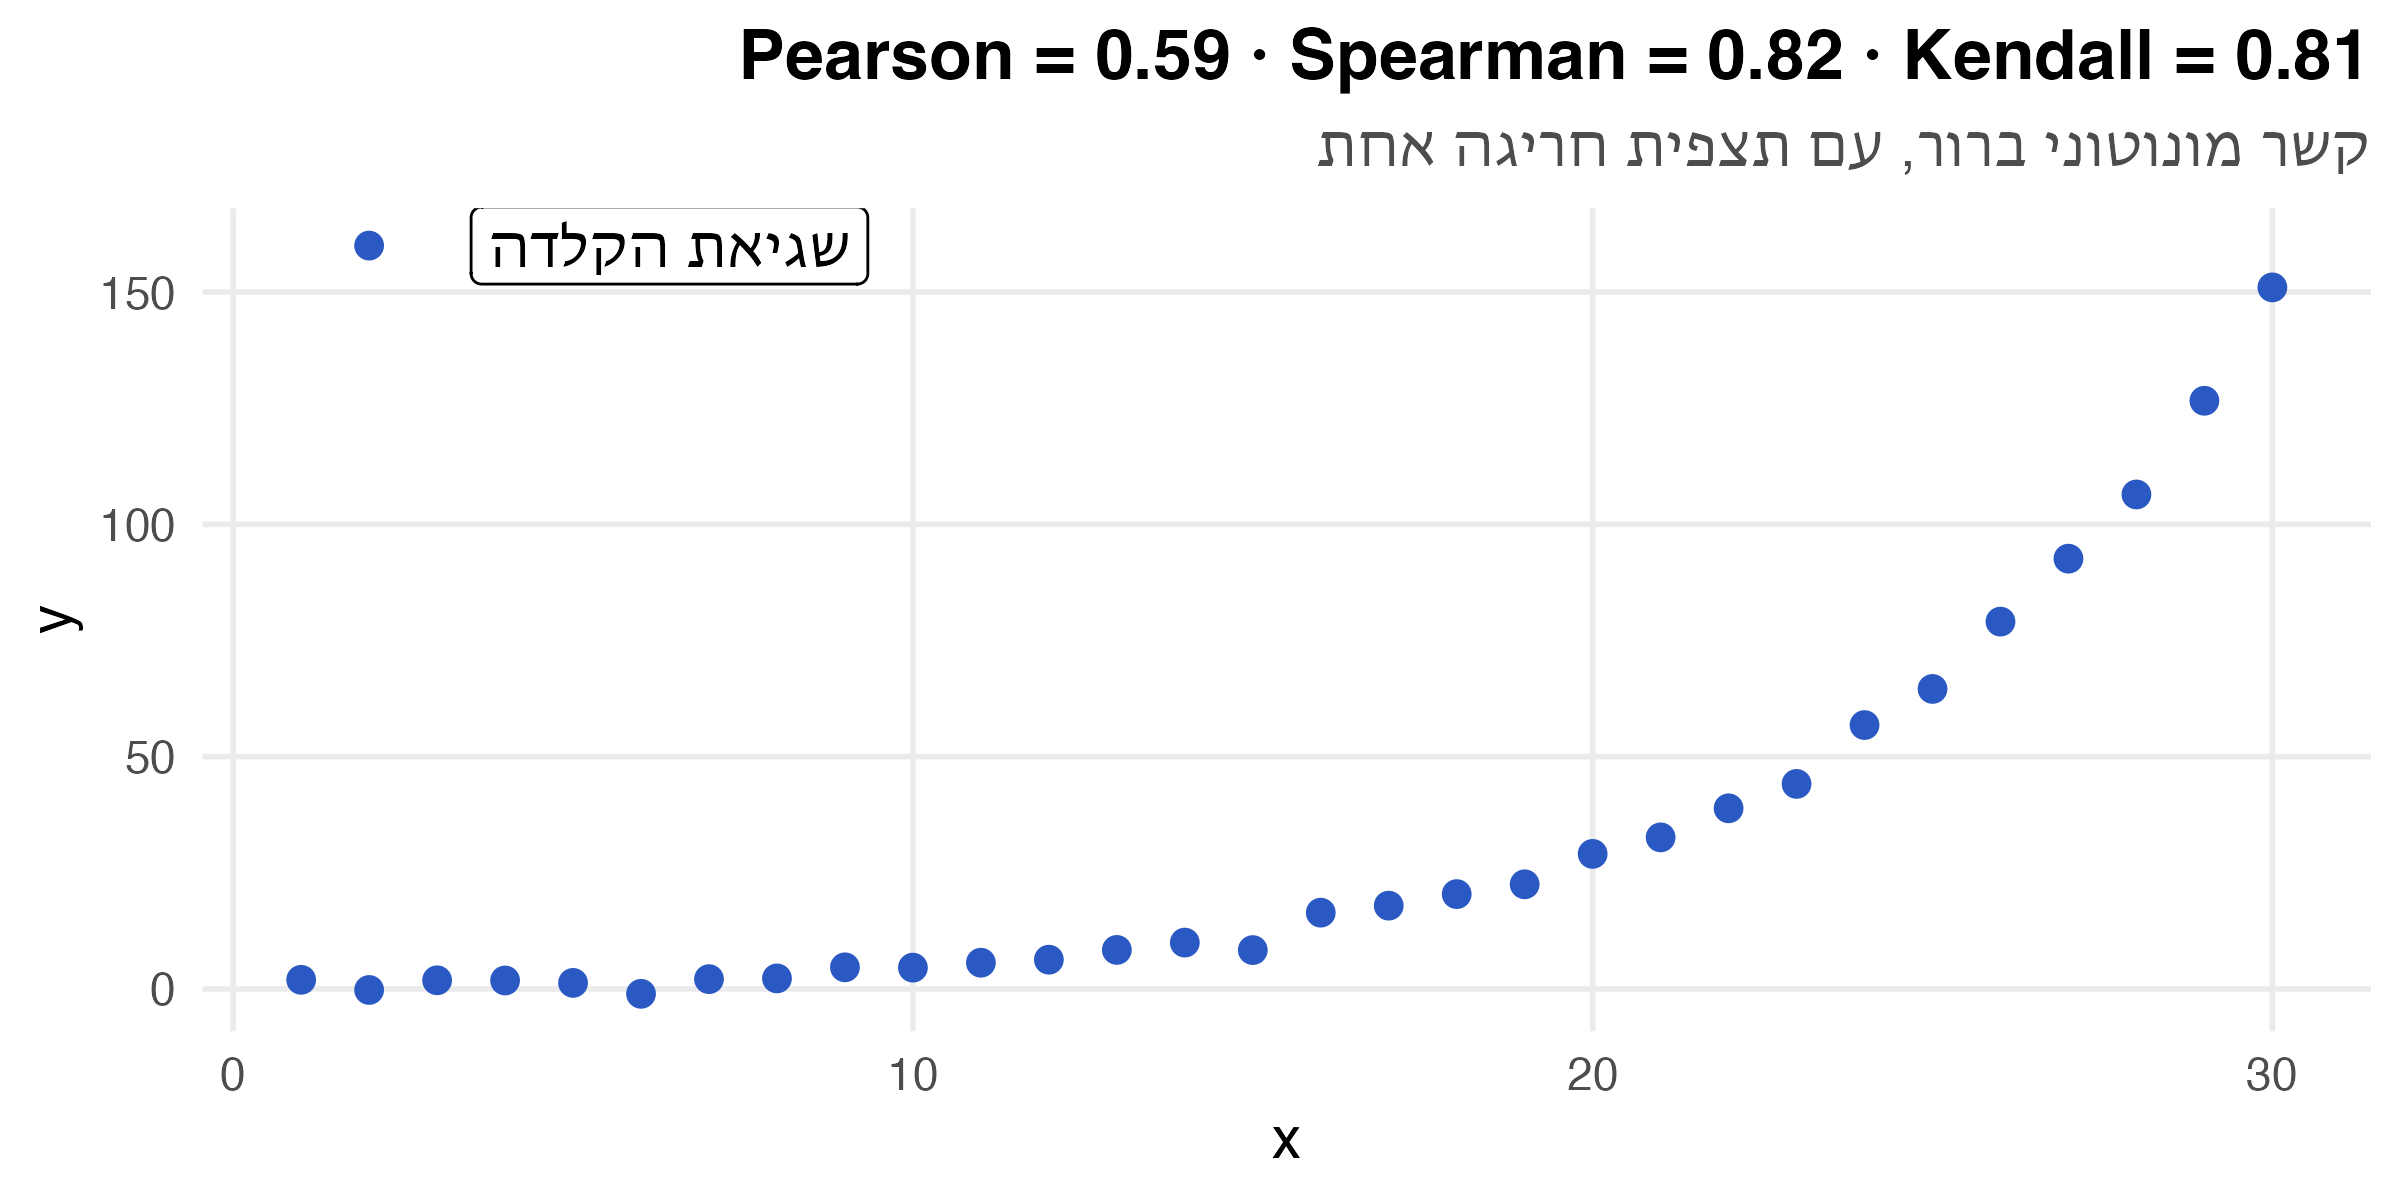
אותם 150 משיבים מסקר הליקרט נשאלו גם “באיזו מידה את/ה אוהב/ת ספרות?”. האם מי שאוהב סטטיסטיקה נוטה לאהוב ספרות פחות?
# Fixed cross-tab (no RNG). Rows: liking statistics (same margins as the earlier Likert slide)
counts <- matrix(c( 2,  3, 5, 10, 16,
                    2,  3, 6,  8,  6,
                    2,  3, 3,  2,  2,
                    7,  8, 7,  5,  3,
                   18, 13, 8,  5,  3), nrow = 5, byrow = TRUE)
survey <- expand_grid(stats = 1:5, literature = 1:5) |>
  mutate(n = as.vector(t(counts))) |>
  uncount(n)

survey |>
  count(stats, literature) |>
  ggplot(aes(stats, literature, fill = n)) +
  geom_tile(colour = "white") +
  geom_text(aes(label = n)) +
  scale_x_continuous(breaks = 1:5, labels = likert_levels) +
  scale_y_continuous(breaks = 1:5, labels = likert_levels) +
  scale_fill_gradient(low = "white", high = nanas_pal[["primary"]], guide = "none") +
  labs(title = "מי שאוהב סטטיסטיקה נוטה לאהוב ספרות פחות",
       subtitle = "מספר המשיבים בכל צירוף תשובות",
       x = "Liking statistics", y = "Liking literature")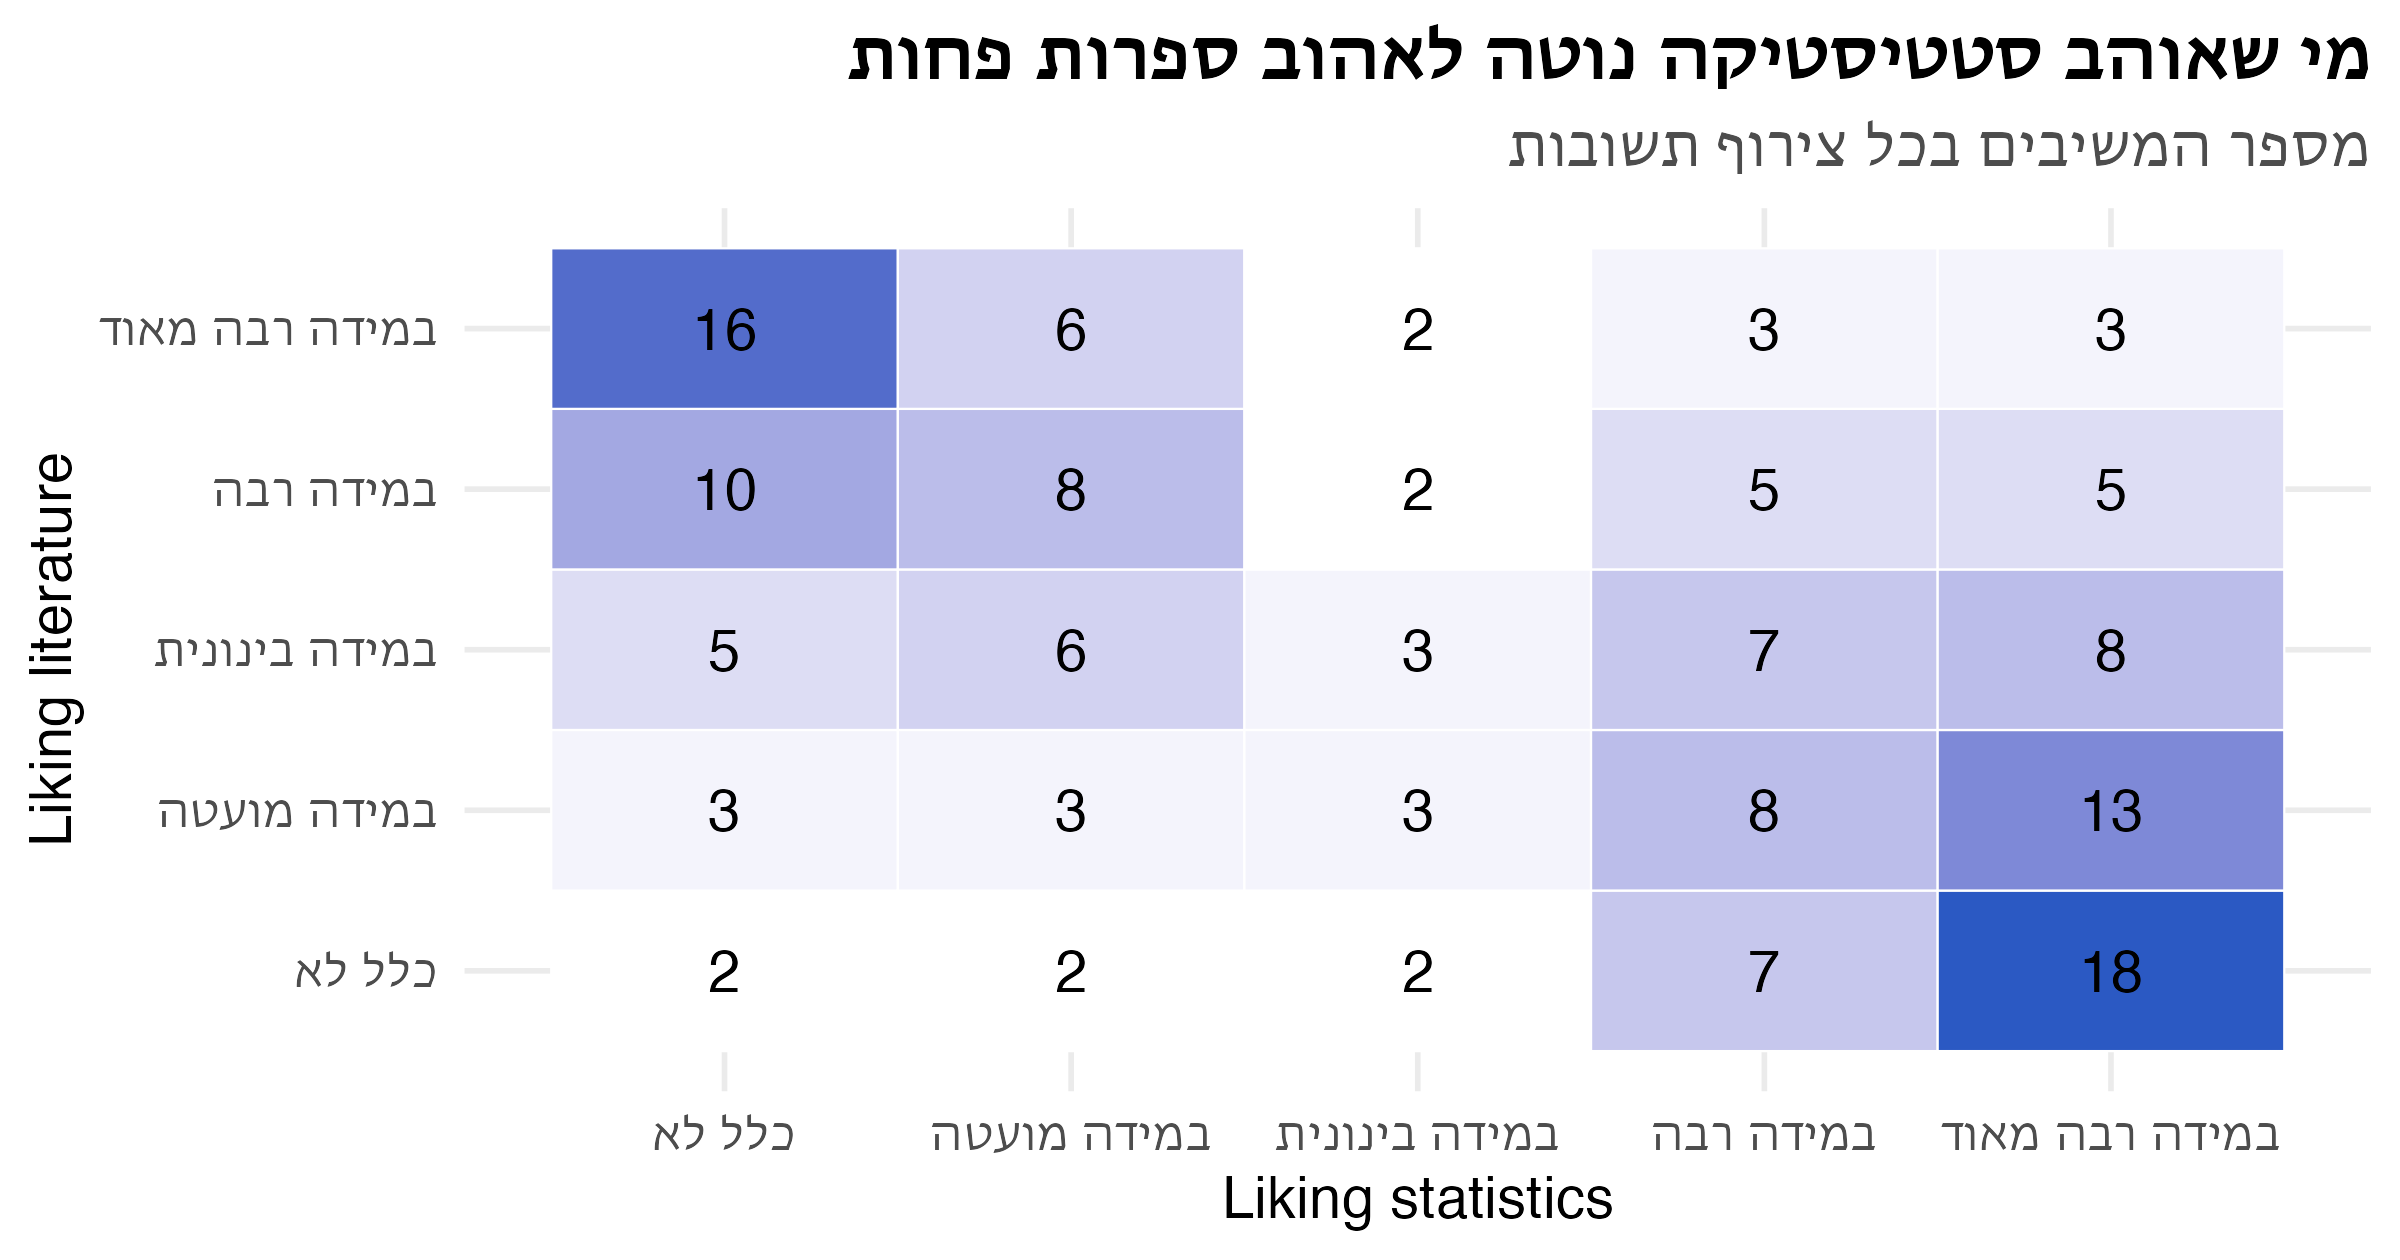
\[ H_0: \tau = 0 \qquad H_1: \tau \neq 0 \]
    Kendall's rank correlation tau

data:  survey$stats and survey$literature
z = -6.2, p-value = 6e-10
alternative hypothesis: true tau is not equal to 0
sample estimates:
    tau
-0.4102
tau שלילי: בזוג אקראי של משיבים, מי שאוהב סטטיסטיקה יותר נוטה לאהוב ספרות פחותp-value קטן מאוד, ולכן דוחים \(H_0\): יש קשר מונוטוני שליליexact = FALSE: יש הרבה מאוד שוויונות (רק 5 ערכים לכל משתנה), ולכן R משתמש בקירוב הנורמלי עם תיקון לתיקו (tau-b)| השאלה | פרמטרי | א-פרמטרי | ב-R |
|---|---|---|---|
| מרכז ההתפלגות | t / Z | סימן, דירוגים מסומנים | binom.test, wilcox.test |
| מזווג | t מזווג | אותו מבחן על ההפרשים | wilcox.test(paired = TRUE) |
| שני מדגמים ב״ת | t לשני מדגמים | סכום הדירוגים | wilcox.test(x, y) |
| התאמה להתפלגות | חי-בריבוע, KS | chisq.test, ks.test |
|
| שתי התפלגויות | חי-בריבוע להומוגניות, KS לשני מדגמים | chisq.test(table(g, x)), ks.test(x, y) |
|
| מתאם | Pearson | Spearman, Kendall | cor(method = ) |
ניתוח נתונים סטטיסטי · תשפ״ז